想像在一條絕熱棒的正中央放置溫度計。棒內某處發生短暫熱脈衝,你記錄溫度如何隨熱量擴散而變化。曲線很平滑,模型擬合也很好;參數導數彼此獨立,局部不確定性計算看來相當理想。這是否代表已經找到熱源?
不一定。左邊一個位置的脈衝,與右邊的鏡像位置,可以在中央產生完全相同的溫度紀錄。問題不在小數位不足、抽到不幸的噪聲,或求解器少做了幾次迭代。在這個對稱實驗下,能夠區分左右的資訊根本沒有進入輸出。某個解釋的局部範圍很窄,仍可以與另一個遙遠、同樣合理的解釋並存。
以下是一個假想感測問題,不是真實火警實驗或工程部署。模型刻意保持簡單:一維區間、一次初始脈衝、反射邊界,以及可以獨立計算的熱核。簡單物理讓我們直接檢查一個較難的設計問題,而不是把它藏在大型模擬器裡。如果總共只能量八次,應該追求局部精度、平均分配測點與時間、打破某種對稱,還是防範相距很遠的競爭熱源?
這個有限研究的答案有條件。中心測點的反例是精確的,卻不代表普通設計方法一遇到非線性就會失敗。零延遲下,六種雙測點設計都沒有出現預先定義的大幅位置錯誤,等間距設計的中位誤差甚至低於 maximin。延遲量測才明顯增加困難,而較複雜的目標函數亦沒有消除困難。重點是按任務選擇實驗,而不是以一個新的通用分數,取代另一個通用分數。
溫度計究竟觀察了甚麼?
熱棒以無量綱區間 表示,溫度遵從擴散係數為 的熱方程。兩端不讓熱量流出;脈衝發生時間已知。正的熱源強度記作 ,位置記作 ,模型為
Delta 符號描述理想的局部初始輸入,不是說普通溫度計在零時刻量到無限溫度:本文每次量測的時間都嚴格大於零。它也不是持續開啟的加熱器。若熱源一直作用,便要把輸入寫進微分方程的 forcing 項,對應另一個前向映射。因此比較熱源重建文獻時,不能只看題目都有「熱方程」,就認為研究的是同一實驗 [6,8,9]。
絕熱區間的特徵函數是餘弦。把解展開成這些模態,得到
每個模態都含三部分:測點在哪裡、脈衝在哪裡,以及觀察之前,擴散已把那個空間模式削弱多少。常數項保留總熱量。對整條棒積分,所有非常數餘弦模態都消失,所以 的積分一直是 。晚期溫度接近 ,與熱源位置資訊大量流失並不矛盾;保住總熱量,不等於保住每一項空間細節。
給定八個測點與時間組合,可以把預測讀數收成向量 ,其中 代表實驗配置。實際觀測寫成
固定的高斯標準差是本研究假設,不是經現場校準的感測器規格。測點位置已知,讀數保留通道標籤,脈衝起始時間也已知。這些選擇讓基準容易解讀,但同時限定了結論不能涵蓋的情況。
反射對稱移除了哪些資訊?
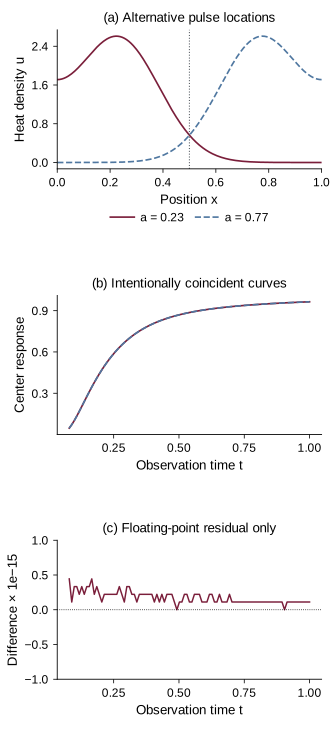
在中央,所有奇數 都滿足 。對偶數模態,把來源由 反射到 ,來源的餘弦係數不變。因此
這個恆等式對每個正時間、每個正擴散率都成立。未知強度也不會打破它,因為兩個鏡像解釋可以使用相同 。即使中央時間序列無限長、完全無噪聲,仍不能選出左右哪個位置。把同一種盲目量測做得更準,可能減少數值波動,卻不能移除觀測映射本身的結構對稱。
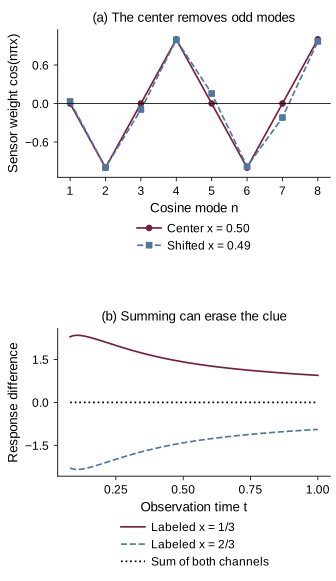
離開中央後,兩個鏡像來源的差值只含奇數模態:
這條公式清楚指出,移動感測器可能取回甚麼線索。但它沒有說,每個偏心測點都能在噪聲下穩定識別所有連續位置。留下來的差值仍可很小,而另一個強度或擴散率組合,也可能模仿其中一部分。打破一個精確對稱,只是設計分析的開始,不是整個問題的終點。
還有第二個容易忽略的區別:兩個位於對稱位置、但保留標籤的感測器,不必然對鏡像來源失明。來源反射時,兩組輸出互換,而不是通常意義下的有序讀數向量不變。在數值控制裡,帶標籤響應距離約為4.50148;把對稱通道相加後,差異才縮到捨入精度。物理配置對稱,仍可以有資訊,因為儀器告訴我們每個讀數來自哪一邊。丟掉標籤,就改變了實驗。
為甚麼滿秩Jacobian仍未解答全局問題?
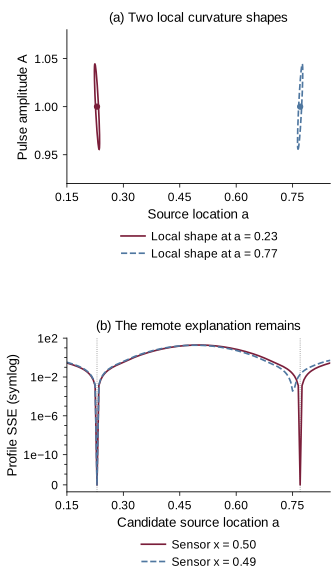
局部資訊問的是:圍繞一個指定解釋,把參數稍為改動,輸出會如何變化?先假設 已知,參數只有 。Jacobian的兩欄是 與 ;在獨立高斯量測誤差下,Fisher資訊矩陣為
固定的中央例子中,最小特徵值約為498.237,並不是零。改變脈衝強度與稍微移動來源,對所選時間讀數產生的局部影響可以獨立。但位置0.77,仍是位置0.23的精確替代解釋。兩件事可以同時成立,因為移動0.54並不是原解釋附近的無限小擾動。
可以把所有可能的觀測向量,想像成量測空間內的一個曲面。導數滿秩,表示曲面在某點有預期數目的局部切向方向,卻不阻止參數域中另一個遙遠部分,走到相同觀測。Pázman與Pronzato正是研究這類更廣的設計問題:非線性模型局部很有資訊,響應面仍可能折回、靠近遙遠解釋,因此需要不只看切線,也看跨越較大參數距離的割線 [1]。
把 也列為未知,並不修復中央對稱。擴展Jacobian增加第三欄 。同一固定例子的資訊特徵值約為119.854、3,874.053及235,504.067,仍全部為正,但鏡像恆等式保持成立。這些是該座標慣例下的局部量,不能直接與前面兩參數問題的最小特徵值比較大小,當成方法優劣分數。
這裡沒有推翻Fisher資訊。它很好地回答局部問題。真正的錯誤,是未檢查其他分支,就把曲率橢圓讀成完整而全局校準的信賴範圍。一個橢圓,不能展示局部近似從未考慮的、不連通的另一個解釋。
一個只知道兩個完整解釋的oracle
加入 nuisance parameters之前,有一個很有用的統計控制。假設只有兩個固定、完整指定的均值向量 與 ,共同協方差為 ,兩個先驗機率相同。最佳分類器比較兩個高斯概似,精確錯誤機率為
其中 是標準常態累積分布。兩個均值重合,錯誤率便是一半;均值相對噪聲相距很遠,錯誤率便小。這個距離使用整個觀測向量,不是只抽出某個時間最大的一次差異。
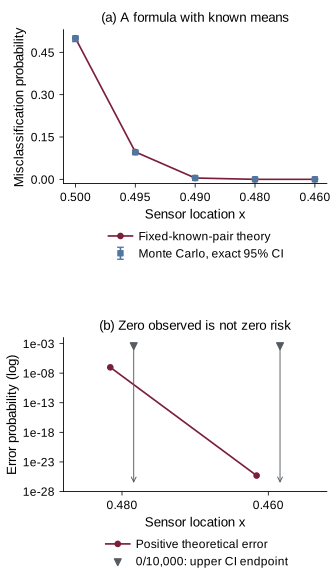
固定 、、 及原來八個時間,把測點由0.5移至0.495,兩個指定鏡像假說的理論錯誤率由0.5變成約0.096995;移至0.49則約為0.004677。使用固定亂數的模擬,對應每10,000次分別錯4,979、956及47次。這是用一個獨立已知的機率公式核對程式,而不是證明高斯分類或熱源反演是新發現。
測點0.48與0.46的10,000次試驗都沒有誤判,但理論機率仍然大於零。零次錯誤不等於零風險。兩個零計數例子的雙側95% Clopper–Pearson區間,上端都是約0.00036882,而不是縮成零。這是固定測點、假說對及噪聲模型下,反覆分類試驗的普通有限樣本區間,類別標籤依相等先驗抽取。
Oracle獲得了真實反演未必擁有的資料:兩個來源強度、兩個擴散率,以及只有兩個可能位置。一旦這些量變成未知,上面公式就不再是新分類器的錯誤率。它是刻意簡化的參照,不是後續所有統計問題的答案。
未知強度,不只是把誤差棒畫闊一點
另一個位置,未必需要使用與真值相同的強度,才能模仿觀測。給定候選位置和擴散率,把單位強度響應記作向量 ,宣告範圍內的最佳強度可以直接寫成
把它代回殘差,就得到 上的剖面曲面。這一步精確消去一個線性 nuisance變數,卻沒有令其餘問題變成凸問題。多個盆地仍可存在;無噪聲中央量測即使已最佳化強度,也保留兩個相等的鏡像極小值。偏心資料可以改變地形,但某一候選的殘差很小,並沒有告訴我們其餘地形發生甚麼事。
擴散率提供另一種補償。 決定空間細節消失多快。相距很遠的候選,可以同時改變熱量及平滑速度。真正審核歧義時,替代解釋必須可以使用自己的 與 ;若要求它沿用真實 nuisance值,便是在不聲不響之間,把題目變簡單了。
因此本研究限制 、、。這些是明確的先驗範圍,不是從現場資料學到的數值。正的強度下限很重要:若容許任意微弱的來源,所有設計都可能遇到近乎零的訊號。同樣,連續位置域一定包含任意接近的兩點;若不先說明要區分的來源相距多少,就不能要求最小響應距離嚴格為正。
數值反演先在81乘41的位置/擴散率網格剖面化強度,保留多個盆地及鏡像候選,再作有界連續refinement。最終每個殘差都直接重新計算。這比只報告一次optimizer執行更有說服力,但仍不等於已證明全局最小。成功停止訊息、很小的殘差,以及全局完備的搜尋,始終是三項不同成果。
未知強度點源重建本來已有大量研究。例如Huynh等人,在明確的噪聲及非退化假設下,以測度表示來源,分析與感測配置相關的重建誤差 [7]。這個三參數模型不取代該套理論;它的用途,是把少數物理參數如何補償的機制畫清楚,同時用獨立控制區分資料不足與數值失誤。
同樣八次讀數,可以怎樣花?
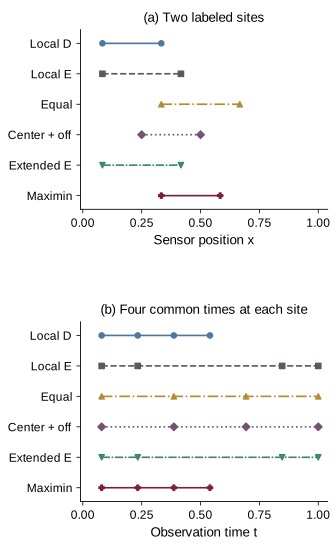
主比較固定硬件及量測預算:兩個不同而有標籤的感測器,各在四個共同時刻讀數。十一個候選位置為 ,其中 ;七個候選時刻為 ,其中 。選兩個位置及四個時間,每個dead time剛好有1,925種可行配置,可以完整枚舉,不必依賴某次佈局最佳化剛好運氣好。
Dead time 指最初不能量測的期間,不是兩次讀數之間的儀器恢復時間。主設定使用 ,啟動之後可觀察的窗口長度相同。原來單一中央測點的八次讀數,仍作為結構控制,但不會假裝使用相同雙感測器硬件,把它混進成本排名。
Local D-opt在固定名義參數 最大化三參數資訊矩陣的log determinant;local E-opt最大化最小特徵值。兩者都不能看見預留真值後再重新定中心。參數尺度固定為0.3、0.35及0.01,令座標慣例明確;尤其E-opt若隨意改單位,哪個方向看來最弱、最佳設計選在哪裡,也可能跟著改變。
等間距基線把測點放在 與 ,配四個等距時刻。另一個預先固定的中心+偏心控制,使用 與 ,時間相同。它測試一個直接的工程想法:保留中央共同參照,同時加入非對稱觀測,但不宣稱這是所有symmetry-aware設計之中最好的方法。
第五種是依據既有全局化設計理論的離散extended-E準則 [1]。它比較候選與名義錨點的響應,並除以縮放參數距離的平方。錨點及分母都有意義:不帶分母的兩兩響應距離,不能換個名稱就說成同一準則。有限參數網格亦是已披露的近似,不是完整重實作原論文的連續設計最佳化。
第六種maximin,在設計網格上最大化相距足夠遠的來源之間、已剖面化強度後的最小響應分離。穩健模型判別早已處理未知競爭參數 [2,3],嚴格預算下的穩健PDE設計也已有成熟理論 [5]。這裡借用相關思想,回答模型特定的比較問題,不包裝成新的最佳設計原理。
「Global」本身也要讀清楚。Qi與Baker在帶噪時間設計中,比較Fisher資訊與Sobol全局敏感度 [4];跨參數分布整合的敏感度,不等於已排除所有遠距參數重合。同樣,多類型PDE感測設計可在不同成本下最佳化資訊增益 [10];本文刻意使用相同讀數成本,沒有借用那些框架的近似保證。名詞相近,不代表目標可以互換。
這裡的「全局分離」究竟指甚麼?
把關心的位置錯誤尺度固定為 。一個配置針對這項任務的分離量,定義為
兩個擴散率代表同一未知實驗的競爭解釋,不是熱棒同時變成兩種材料。同一解釋的整個讀數向量,必須共用同一強度與擴散率;不能對每個觀測另選一組參數,否則便換成更靈活的模型。正的強度下限與非零位置分離,排除了令目標平凡地變成零的兩條路。若這個量為正,它能在宣告範圍內排除足夠遙遠、均值卻近重合的來源,卻不等於證明所有任意小位置尺度上的單射性。
給定核向量 ,兩個 nuisance強度可以用有界二次計算消去。至少有一個最佳強度可以取在下界:否則同時把兩個強度向下縮,便可減少非零響應差。檢查兩條下界邊即可得到最小值,不必把強度粗略網格化。但餘下的來源位置與擴散率,仍需要全局搜尋或包絡。
選擇設計時,位置網格由0.15到0.85、間距0.1的八點構成,另加0.23與0.77;擴散率是0.04、0.05及0.06。Maximin只是在宣告的有限配置族與這套參數網格準則內最佳,不是在任意測點軌跡、任意連續採樣時刻或所有參數不確定性下全局最優。
有一個不等式方向尤其重要。在有限子集取最小值,只要沒有數值錯誤,就不會比真正連續最小值更小。因此網格結果是連續最壞分離的上界,而不是下界。很大的網格分離可以支持下一步研究,但本身不能認證:那些尚未抽到的參數對,不會比網格上最難的一對更難。
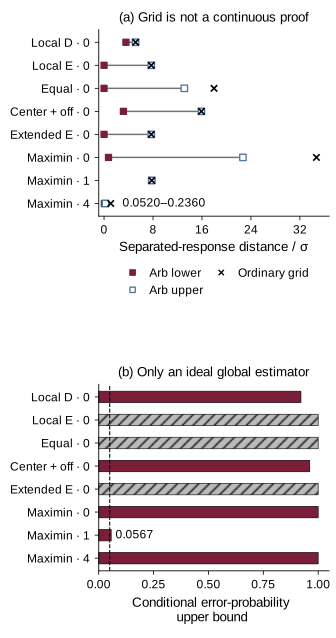
零延遲下,未除以噪聲的網格距離約為:local D-opt 0.257568、local E-opt及extended-E 0.385917、等間距0.898403、中心+偏心0.795387、maximin 1.735078。這些不是錯誤機率。Maximin在自己最大化的分數上勝出並不意外;科學問題是,換到未見參數及另一個推論任務,這個優勢是否仍存在。
最難的一對,也未必就是開首用來說明問題的鏡像來源。零延遲local D-opt把測點放在 及 ;它的網格見證比較 與 。兩個位置相差0.2,第二個來源使用較強脈衝及不同擴散率補償,不是把0.23直接反射到0.77。Maximin則選擇 與 ,最難來源對也隨配置改變。
這個例子讓抽象的「最壞情境」變得具體。Local D-opt的名義來源在0.23附近,兩個左側測點有理由對那個局部問題敏感;但設計允許的來源域一直伸到0.85,不能因為名義位置附近的導數很好,就假設遠端也有相同保護。反過來,也不能只憑測點分布不平均,就斷言它必然在測試中失敗。配置本身、熱核、強度範圍、時間及噪聲必須一起評估,幾何直覺只是幫助理解,不代替運算證據。
這也解釋為甚麼本文沒有只最佳化一組吸引眼球的左右鏡像。若只對那一對挑選測點,很容易得到漂亮分離曲線,但可能忽略來源域的其他角落。設計網格納入整個宣告範圍,預留測試再離開該網格,就是為了令「成功」不只代表成功排除了我們一開始已知道的那個反例。問題不是能不能畫出一個好例子,而是同一配置如何面對尚未用來挑選它的解釋。
離開設計網格後,實際發生了甚麼?
64個預先凍結的Sobol參數組合提供範圍內的預留真值,每組有32個獨立高斯噪聲向量,各方法配對使用相同噪聲。它們是固定基準案例,不是從真實熱棒母體獨立抽出的64個樣本。零延遲比較噪聲0.025、0.05及0.1;有延遲時使用0.05。六方法合共30個條件,產生61,440次連續反演。
主要的大幅錯誤指標為 。這是預先宣告的研究尺度,不是普遍工程容許值。中位誤差呈現典型數值位置準確度,大幅錯誤計數則問程序有沒有選到相當遙遠的答案。兩者都值得看,因為目標一變,方法排名也可能改變。
在 、 下,各方法都有2,048次反演,且大幅位置錯誤全部為零,但中位數不同。等間距約0.00246372,中心+偏心0.00289780,maximin 0.00311622,local E-opt與extended-E均為0.00347328,local D-opt為0.00608662。按這個摘要,最簡單的配置最好,儘管它在最佳化網格上的分離分數較小。
對一個很容易被預先寫成「新準則較好」的故事,這是重要負面結果。中央反例說明局部秩不推出唯一性,但沒有預言:所有局部最佳化的帶標籤雙測點配置,都必定在這些預留案例失敗。最壞參數對設計,也未必最小化平均或中位反演誤差;它防範的是特定任務下、特定不確定性中的情況,是另一種目標。
當 ,六種配置仍全部沒有大幅位置錯誤,但中位誤差上升。當 ,每2,048次的錯誤計數變成:local D-opt、local E-opt及extended-E各31,等間距72,固定中心+偏心124,maximin 29。不會把29與31這兩次之差,包裝成普遍或已建立統計顯著性的優勢。資料是配對的,部分方法的實際配置亦完全相同。
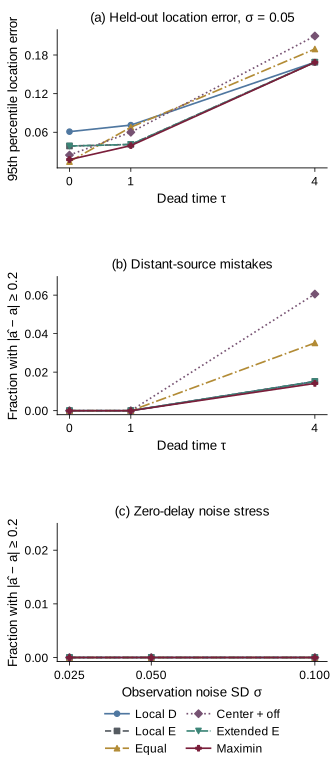
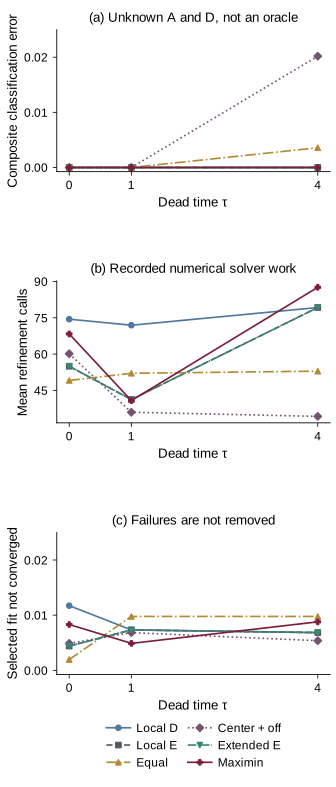
另一個複合分類器知道只有兩個可能位置,但不知道強度及擴散率;它在每個假說下剖面化兩個 nuisance。三組鏡像位置、兩個標籤、兩個強度、兩個擴散率及128次噪聲,令每條件有3,072次決策,總數92,160。延遲四時,等間距誤判11次,中心+偏心62次,另外四種準則均為零;更早的複合分類條件也全部為零。
這不與連續反演錯誤矛盾。只在兩個相距很遠、指定好的位置中選一個,可能遠比在 nuisance補償下估計任意連續位置容易。分類器與反演器擁有不同候選集,產生不同輸出。若不講任務,把兩者都叫作「識別準確率」,反而會藏起本研究要揭示的分別。
零也必須連同分母來讀。對一個固定真值,做 次獨立噪聲試驗而沒有錯誤,雙側95%精確區間的上端是
只有32次噪聲重複時,上端約為0.108881。這不是說真實錯誤率便有一成,而是說如此少的零計數,尚不足以把固定真值的錯誤機率壓到很小的上界。把同一配置的2,048個結果全部加起來,又混合了64個可能具有不同難度、不同錯誤機率的參數情境。總數比較大,不能自動轉成每一個來源都得到相同程度的保護。
逐真值區間與有限案例計數,回答的正是研究實際重複的問題。一次獨立重複是加入完整八維噪聲向量,然後重新反演或分類;八個時間讀數不是八次獨立的演算法成功試驗,64個Sobol位置也不是從真實熱源母體隨機抽出的64個新實驗。尤其在某些配置完全相同時,把各方法紀錄再合併,並不會憑空增加物理資訊。
因此圖上的零與非零都會保留,而結論的語氣取決於問題尺度。零延遲下各方法沒有大幅錯誤,是一個清楚的有限負面比較:沒有證據支持這次研究必須用更複雜方法,才能避免宣告的大幅誤判。但它既不是每個連續真值都不會出錯的定理,也不能掩蓋中位誤差、參數邊界與求解狀態之間仍有差別。
認證必須覆蓋網格點之間的空間
連續下界需要的不只是畫更密的圖。對選定配置,計算以向外捨入的實數球運算包絡熱核及導數,納入明確的無窮級數尾項,再細分四個非線性的來源/擴散率座標;強度仍維持有界剖面。每個保留區間單元提供下界,可行參數見證提供上界。
程序有固定50,000個區間單元的工作上限,原始距離包絡寬度目標為 。尚未處理的可行區域不會消失。如果下端為零而上端為正,結果在這個預算下就是unresolved,而不是已證明有精確別名。反過來,正下界也只認證宣告的分離問題,不會證明模型本身正確。
如果模擬已經很好,為甚麼還要付這筆成本?因為模擬檢查有限真值,而下界必須面對每一個容許的遠距競爭者。兩個程序用不同資訊,付出不同成本。數學上完全有效的下界,仍可能保守到統計上沒有幫助。交代這種限制是結果的一部分,不是應該刪走的尷尬。
假設獨立核對的原始距離下界是 。對理想而精確的全局nearest-model estimator,三角不等式給出簡單而保守的推論:噪聲向量足夠小,就不會出現尺度 的位置錯誤。在凍結的高斯模型下,
它不是固定兩均值的高斯oracle,也不會自動成為實驗中數值剖面求解器的錯誤界,因為未證明後者對每個帶噪向量都找到精確全局最小。分開這兩件事,才能避免把有用的數學推論,接到尚未滿足其前提的算法上。
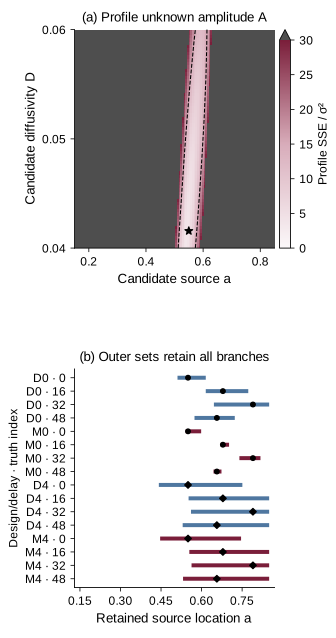
八項包絡計算全部先達工作量上限,尚未收窄至目標寬度;五項保留正分離下界,三項仍是零下界未決。零延遲時,局部D-opt的原始距離包絡為[0.178777,0.257569],maximin則為[0.036311,1.134591],顯示端點向外取整。兩個區間重疊,鬆緊亦不同,不能按下端大小排列設計優劣。Maximin在延遲一時反而有很窄的[0.388936,0.389382]包絡,但理想估計器的充分錯誤上界約為0.056719,仍高於5%目標;到延遲四,上界幾乎是一。八項均未證立5%目標。較緊的證書可以描述較差的實驗,而充分界限沒有判別力,也不代表分類本身不可能。
另一種不確定性展示直接使用觀測噪聲。以 表示宣告的緊緻參數範圍,定義
這是噪聲球相容集合。八個自由度來自觀測向量,不是八減三個擬合參數。在精確模型下,真參數逐例以95%機率落在其中。向外包絡保留所有尚未證明在球外的區域,包括未決單元,所以位置投影可能包含幾個分離部分。它不是Bayesian credible set,也不是局部概似比區間;同時展示十六個例子,亦不會自動得到全體同時成立的95%保證。
這十六個固定例子的外包絡位置投影全部連通,亦全部包含生成來源;沒有出現不連通的位置集合。每項計算仍保留未決單元。零延遲時,maximin在這四個真值下的顯示投影均比局部D-opt窄;到延遲四,兩者保留寬度均約0.29至0.32。這些外集合揭示單一估計隱藏的不確定性,但不表示每個保留位置都已證明相容,更不把十六次保留真值當成同時95%保證的驗證。
理解這個門檻,可以暫時不要想「已擬合了幾個參數」。先固定真正生成資料的那組參數,在它的預測位置計算殘差,剩下的正好是八個量測噪聲。把每個噪聲除以已知標準差,再平方相加,才得到八自由度的卡方分布。這裡沒有先用同一批資料估計真值再扣掉參數數目,因此不能機械地套用線性回歸殘差自由度的口訣。非線性、邊界解與多個盆地,也令其他區間近似需要額外條件。
位置投影問的則是另一個存在性問題:對某個位置,是否仍有至少一組範圍內的強度與擴散率,令預測與觀測相容?某位置下部分參數已被排除,不代表整個位置都應刪去。只有當所有容許 nuisance組合都能被證明不相容,才可把那段位置剔除。如果計算尚未完成,寧願保留未決位置,也不能把求解器沒有找到候選,寫成那裡不存在候選。
這種做法可能產生較闊、甚至分成幾段的圖形,視覺上沒有單一橢圓那麼俐落。但那正是資訊結構的一部分。把所有區間連成一個大範圍雖可更保守,卻會遮掉兩個不同解釋之間其實已被資料排除的空隙;只挑最窄的一段則相反,可能丟失真正仍然合理的分支。本文保留不連通部分,目的不是令不確定性看來更大,而是讓讀者看見資料究竟排除了甚麼、仍容許甚麼。
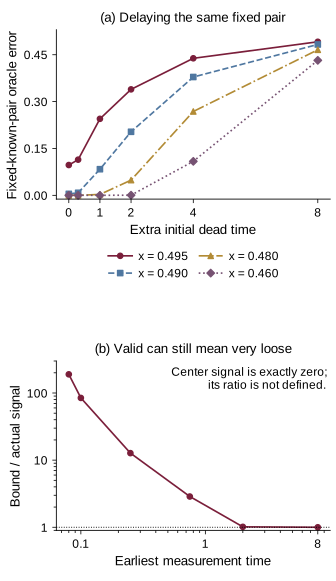
等待,可能移除線索,而不只是增加噪聲
擴散削弱高空間頻率的速度比低頻更快。鏡像來源的差值依賴奇數模態,而這些模態隨時間指數衰減。對固定偏心測點,把第一個奇數項抽出,再用幾何級數控制其餘尾項,可得一條基本界限;只要全部觀測都在 之後,
界限解釋機制,但品質取決於區域。在 、、,界限除以真實單時刻差異,在時間0.08約為189.82,在0.1約84.50;到時間二約1.015,時間八則幾乎是一。有效的早期上界,可以鬆到完全無法協助判斷。
正中央的真實差異為零,但這條特定尾項界仍為正,因為推導時捨去了部分空間因子。在這裡除以真實差異沒有意義,因此比例記作不適用。這個具體例子說明,解析不等式、準確估計及可用的決策餘裕,必須分開。
原來測點0.49、八時刻的已知兩假說實驗,把整個窗口延遲四單位,理論錯誤率升至約0.378635;延遲八單位,則約0.482878。感測器的假定噪聲沒有改變,分類卻已接近擲硬幣。資訊是讀數到達之前,被物理擴散抹去的。這不是聲稱所有感測響應或每一個隨機噪聲實現,都必定隨延遲單調變差。
不成功的擬合告訴我們甚麼?
61,440次反演中,391個最終選出的有限估計,求解器狀態為不成功;所有盆地合共另有902次不成功refinement嘗試。這是不同計數:一個觀測可啟動多次refinement,一次不成功也可以與另一個有用候選並存。反過來,返回有限點並不代表已滿足停止準則。準確度摘要保留這些有限估計,不會為了改善數字而刪去不方便的狀態。
邊界解也是提示。延遲四、噪聲0.05時,local D-opt的2,048次反演中有1,715次碰到邊界,maximin則有1,753次。這個計數包括強度、來源位置或擴散率任何一項宣告邊界。它們不自動是錯的,因為約束本來就是估計問題的一部分。但如果估計經常貼著範圍邊界,就更不能把無約束的局部橢圓當成完整不確定性故事。
額外控制只在零延遲、sigma=0.05下,使用範圍外的擴散率0.03與0.07,每方法256次反演,不會看完結果再擴闊擬合範圍。六種配置在這些特定失配案例,都沒有超過0.2的位置錯誤,但大量估計碰到參數邊界。這不證明模型假設不重要:位置摘要可以看來尚可,物理解釋卻靠不正確的補償維持擬合。任何範圍內認證,都不會套到這些範圍外真值。
數值控制針對的是另一類潛在失敗。位置與擴散率導數有獨立核對,餘弦級數與images表示互相一致,總熱量守恆;60、120及240模態在7,623個宣告控制點一致。最高截斷的普通浮點尾項數值可以下溢,不能把它當作尾項精確為零,或升格成區間認證。兩種計算一致是有用證據,但意義取決於它們是否共享同一近似。
兩次完整執行所保存的科學結果一致,計時紀錄另存。
最後一幅圖的工作量,是refinement目標函數評估次數的平均,不包含粗參數網格、配置枚舉或區間驗證,因此不是端到端速度,也不是隔離硬件後的計時結果。某種設計可以較容易擬合,卻較難認證。這些成本應該分開保留,而不是縮成一句「某個準則比較快」。
更好的實驗,應該嘗試排除甚麼?
核心不是determinant抽象地好不好,或maximin是否在所有情況比較先進,而是哪一類替代解釋對任務真正重要。若運作範圍本來已知道得很窄,局部設計可以很合適;若誤選遠距分支會造成嚴重後果,全局分離目標便可能更貼近需求;若廣泛覆蓋比名義局部方向更重要,等間距仍可以很有競爭力。
Nuisance假設值得與測點位置同等重視。若強度可趨近零,在本研究意義下,任何有限噪聲實驗都不能均勻分開所有容許訊號;若起始時間未知,擴散率與經過時間便可能以本文排除的方式互相補償;若感測器在空間取平均、反應有滯後、校準不確定,或噪聲彼此相關,前向映射與不確定性計算都會改變。這些是獨立擴展,不是曲線漂亮就自動獲得的額外可信度。
近期熱反問題理論也提醒我們必須具體。稀疏邊界熱通量,在與中央內部溫度截然不同的條件下,可以建立來源唯一性 [8];持續空間熱源配終端觀測,會得到另一種感測配置問題 [6];現代延遲觀測穩定性結果,也帶有自己的幾何、正則性及觀測假設 [9]。它們既沒有被簡單反射例子推翻,也不能直接貼到八次帶噪脈衝讀數上。
因此下一個有價值的實驗,應一次改一項宣告假設,例如有限感測寬度、不確定起始時間,或更廣的擴散率範圍。在加入複雜度之前,這個小研究先問:推論目標、資料標籤、nuisance處理與設計成本,是否已經比較得誠實?如果輸出已丟掉讀者需要的區分,再大型的模型也不能把它救回來。
結論
局部精度與全局唯一,是不同成果。中央熱量測令這個分別成為精確恆等式;同預算比較則說明,不能因此自動宣布較複雜設計準則勝出。早期有限基準中,幾種普通配置已有好表現;延遲與nuisance補償,才令後期反演更困難。合理做法是保留競爭解釋,在設計網格以外測試,並如實交代哪個保證仍保守到沒有實際幫助。
閱讀專案概覽,一併了解研究問題、方法及限制。
參考文獻
- Pázman and Pronzato. Optimum design accounting for the global nonlinear behavior of the model. Annals of Statistics, 2014.
- Dette, Melas and Shpilev. Robust T-optimal discriminating designs. Annals of Statistics, 2013.
- Atkinson and Fedorov. The design of experiments for discriminating between two rival models. Biometrika, 1975.
- Qi and Baker. Optimal experimental design for parameter estimation in the presence of observation noise. 2025 preprint.
- Chowdhary, Attia and Alexanderian. Robust Optimal Experimental Design of Infinite-Dimensional Bayesian Nonlinear Inverse Problems. SIAM Journal on Scientific Computing, 2026.
- Aarset and Nguyen. FEM-based A-optimal sensor placement for heat source inversion from final time measurement. 2025 preprint.
- Huynh, Pieper and Walter. Towards optimal sensor placement for inverse problems in spaces of measures. Inverse Problems, 2024.
- Gong, Jin, Kian and Liu. Identification of a Point Source in the Heat Equation from Sparse Boundary Measurements. 2026.
- Li, Li and Zhou. Inverse Heat Source Problems from Boundary Flux and Interior Observations on Sets of Low Hausdorff Dimension. 2026 preprint.
- Maio, Alexanderian, Koval and Nicholson. Multi-type Sensor Placement for PDE-based Bayesian Inverse Problems. 2026 preprint.