想像你收到一小段正在移動的圖樣。你不知道它由哪條方程產生,卻需要預測接下來的變化。模型可以在回答前多「想」一會:讓同一個更新步驟重複更多次,重新整理眼前的觀測。多花這些計算,預測應該會更準吧?
這個直覺很吸引。多一次迭代,似乎就能把動力學估計得更仔細。但同一步驟也可能讓模型更忠於一筆帶噪量測、一個缺乏資訊的方向,或一個與真正預測目標不完全一致的替代損失。進度列上的數字下降,不代表未來的誤差也會下降。最佳化器不知道哪些殘差是物理訊號、哪些只是感測誤差;模型和資料必須先提供這種區分。
本文使用假想的預測情境,不是天氣預報或工程部署。實驗選擇穩定 affine 系統,以及週期域上的平流–擴散方程。兩者都能獨立求出乾淨參照解。刻意從簡單問題開始,是為了把失敗原因看清楚:當預測出錯時,不必先懷疑所謂真值是否只是另一個求解器的誤差。
研究起點是 Lai 等人的 2026 年預印本 Test-Time Forecasting,把循環 linear attention、動力學回歸,以及推論期間適應的小模型連接起來 [1]。這次成果是小規模獨立重實作,不是完整重現原作者的資料、最佳化器或數值結果。DMD、測試時適應、Fourier operators,以及 attention 與梯度下降的關係,都有明確先行工作 [2–10]。這裡問得更窄:在宣告的觀測方式和固定評分規則下,額外計算究竟買到了甚麼?
答案有條件。額外更新改善了部分宣告的預測,但更好的 context fit 與更好的未來預測,亦有分道揚鑣的個案。平方正規化 LDS 模型可用,原文規則版本卻失敗;pretrained Fourier 初始化改善 identity,但乾淨資料的直接最小平方更準。這些結果都不是 test-time scaling 的普遍定律。
模型究竟可以看見甚麼?
Context 是發出預測時已經收到的一段觀測;未來則是另一段序列。這個分別看似理所當然,實驗卻可以用很不起眼的方式越界:看過未來誤差後才選最好的迭代次數、用較後的真值平滑先前量測,或者讓滾動預測器每一步都讀到真實下一狀態,而不是自己的上一個預測。
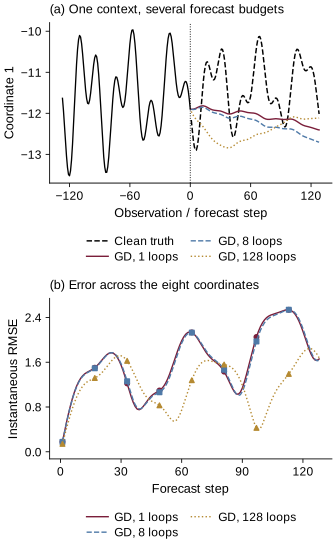
把 context 寫成矩陣 ,每一列代表一個時刻的狀態。最後一列是目前最新觀測,不是未來的第一個答案。進行 autoregressive rollout 時,每次預測又會進入下一個 context。因此,誤差不只改變當前答案,也會改變產生下一個答案的資訊。一個很好的單步預測,不能直接證明後續 128 步都可靠。
本研究把這道界線固定下來。所有方法看到相同初始條件、相同帶噪 context,從最後一個帶噪觀測開始預測。乾淨未來只交給評分程序,不會回傳給學習器。Affine 系統的真實平衡點也是評分資訊,不是免費加入前處理的物理知識。驗證資料可以用來挑選正則化強度或停止規則;測試未來不可以。
這也解釋了為甚麼「有沒有使用未來」不能只靠模型輸入介面判斷。即使未來沒有直接放進輸入,若研究者按測試結果挑參數,資訊仍然經由選擇過程進入方法。預測器與調參程序應該一起接受檢查,不能把兩者割開後,只宣稱模型本身沒有洩漏。
為甚麼先從線性回歸開始?
Dynamic mode decomposition,簡稱 DMD,是回答「哪個傳播規則符合這些連續 snapshots?」的一個起點。它不等於宣稱所有物理系統都是線性的,而是一個幾何結構可檢查、答案也能由獨立方法計算的回歸問題 [2,3]。先把這個問題做清楚,再加入學習型更新,才容易知道改進來自哪裏。
令 包含 context 除最後一列外的狀態, 則包含除第一列外的狀態。每一列是一個狀態,線性預測矩陣 令 接近 。平方殘差目標為
Frobenius norm 把不同時刻和通道的平方差加起來。這個目標問的是:模型能否解釋已經觀測到的相鄰轉移?它沒有直接要求很久以後的預測準確。最小平方解可以用 pseudoinverse 表示,但是否唯一辨識了傳播矩陣,取決於 context 有沒有激發足夠方向。
例如,一段運動若始終沿着一條直線,便沒有告訴你算子在直線以外如何作用。多收集一些完全相同方向的運動,可能讓該方向的估計更穩,卻不會補上其餘方向。這是 rank 的問題,不只是訓練時間不夠。Tu 等人對 linear consistency 的討論,正是把這種限制放進 DMD 的解讀,而不是當成可忽略的數值細節 [3]。
Affine 動力學還有固定外力,可以加入一個恆為一的座標,改寫成增廣線性系統。估計算子與檢查 rank 時,這個常數座標都必須一致處理。否則偏移量可能被誤認為動態模態,或者所謂八維頻譜恢復,漏掉了令模型成為 affine 的那一部分。增加一個座標不是形式上的小修補,而是改變了可辨識問題的完整維數。
多走一步梯度下降,改變的是哪個時鐘?
對宣告的平方損失,梯度下降為
這裏的 計算最佳化步數,不是物理時間。多走一步,是利用同一組 snapshot pairs 移動擬合的傳播矩陣;它沒有推進真實系統,也沒有增加一筆新觀測。把這兩個時鐘混在一起,容易讓「更多深度」聽起來等同「更多知識」。
的 singular values 揭示不同方向的更新速度。對應 singular value 的誤差,每步乘上 。大的 singular value 對應陡峭方向,小的對應慢方向。對某方向適中的步長,可能在另一方向 overshoot。當 非零,非零 singular directions 的標準收縮條件是
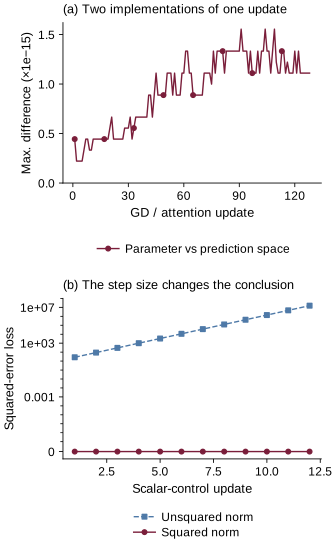
分母的平方非常重要。若資料整體放大,曲率會按平方改變;只用未平方 norm 的分母,不會保留正確縮放。目標 v1 附錄 B.2 使用未平方 norm 的論證,因此本研究保留該規則作診斷,同時另測平方 Frobenius norm 的正規化版本。這個局部代數不一致,不代表原論文所有實驗都無效。
當 ,除以 norm 不是有意義的步長規則;梯度為零,資料完全沒有提供關於 的資訊。當 秩不足,null space 中的分量同樣不可見。若 是投影到零空間的正交 projector,便有
所以 fitted values 收斂,不等於參數矩陣收斂至唯一答案。零初始化可以選出最小 norm 解,其他初始化卻會保留不同的不可見分量。如果沒有交代初始化,就直接寫「迭代得到 pseudoinverse」,便抹掉了實驗本應揭示的歧義。
這不是主張梯度下降不好,而是指出它很忠實地解答了指定問題。當問題對某個方向沒有要求,最佳化器不會憑空補出物理答案。把這個限制說清楚,反而能區分正常的不可辨識,與真正的程式錯誤或不穩定更新。
Linear attention 在哪一步出現?
令 選出 context 除最後一列外的部分,因此 ,並定義預測空間 iterates 。把完整 context 乘到參數更新前面,得到
這個矩陣乘積具有 linear attention 的形式:query–key 乘積,再乘 values。此處的 values 是殘差,時間平移也是構造的一部分。在這個回歸、這些變數及一致初始化下,關係是精確的。它不是「任何 Transformer 都必然在做 DMD」的證明。
學習型模型可以改變這個關係。Queries、keys、values、recurrent state 和 output 各自使用可學習投影,可能形成更有用的預測器,卻不再等同原本的二次損失最佳化器。Encoder 可以改變重視哪些方向;時間濾波器可以改變比較哪些相鄰資料。一旦這些選擇是自由的,行為就需要實驗證據,不能繼承解析 GD 的收斂標籤。
Linear attention 可以實現梯度式回歸的基本想法,早於本研究 [6]。EDMD 也早已利用選定 features,把非線性預測變成較豐富表示中的線性回歸 [4]。提升到新座標,不會自動消除近似誤差、條件數問題或分布轉移。EDMD 的收斂結果具有明確抽樣與函數空間假設,不能拿來替一段有限、帶噪、投影又經訓練的 context 保證 [5]。
這種構造的吸引力,不在於把預測變成自動正確,而是讓部分計算可以解釋。研究者能逐項追問:它降低哪種殘差?Context 告訴了哪些方向?加入訓練後,哪些精確條件已經不再成立?這些問題比只把模型稱為「會思考的網絡」更有操作性。
620 個參數,學到的是甚麼?
線性系統案例重建小型循環架構,而不是換成大型通用網絡。8→9 affine encoder 有 81 個參數,9→8 decoder 有 80 個;五組 9×9 Q/K/V/Z/O projections 共 405 個,兩點時間濾波器共 54 個,總數為 620。參數數量和時間對齊都需要測試:名稱相同、filter convention 不同的模型,實際上可能在回答另一個數值問題。
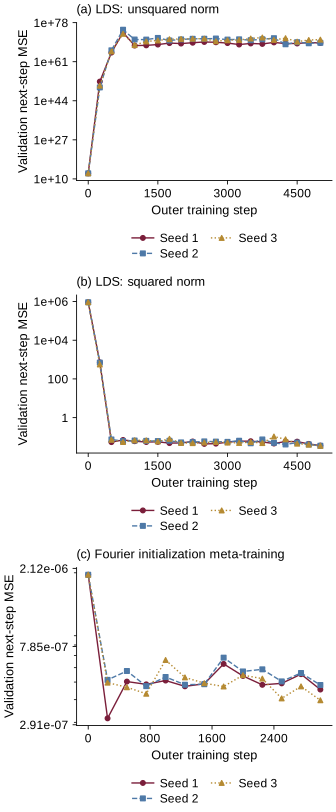
兩種正規化版本分開訓練。每個版本使用三個訓練 seeds、5,000 個 outer steps、batch 16,以及訓練時固定 35 次循環。外層採 AdamW,最高 learning rate 為 、weight decay 為 、gradient norm 上限為一,最後十分一訓練步數線性降 learning rate。Checkpoint 只按驗證資料選擇。
這個訓練預算明顯小於來源研究,而且 AdamW 取代了原文 SOAP。這是已宣告的獨立選擇,不是 AdamW 與 SOAP 的受控比較。若小型運算沒有重現某效果,仍可能涉及訓練預算、最佳化器、資料、數值實作,以及效果本身。獨立測試可以排除部分程式錯誤,卻不能把剩餘可能性直接縮成單一因果答案。
同樣地,通過參數數量測試,不等於模型真的學到了理論中的更新。它只表示實作符合宣告的架構規模。要判斷學到甚麼,需要同時看訓練曲線、驗證結果、不同循環數下的輸出,以及後續動態診斷。研究應容許這些證據不完全一致,而不是挑其中最好看的一項作總結。
六個 LDS fits 都完成 5,000 步,但在保存的已訓練 checkpoints 中,原文規則 seeds 的最佳 validation MSE 仍介乎 至 ;平方版本介乎 0.0347852 至 0.0357830。選擇範圍是第 250–5,000 步,不包括初始零步診斷;原文規則 seeds 都選第 250 步,雖然初始診斷更好。完成與學到有用預測器不是同一回事;這個較小 AdamW 結果不能自動否定原作者 SOAP 模型。
為甚麼選最終會安定下來的系統?
參照系統滿足
矩陣是穩定的,包含兩組衰減振盪及四個非振盪衰減模態。精確解可寫成
平衡點是固定偏移;真正隨時間改變的部分承載動態。一個預測若一直停留在很大的平衡值附近,即使錯過較小的振盪,原始相對誤差仍可能很好看。因此同時報告 raw error,以及用平衡點中心化乾淨運動正規化的誤差。中心化是評分視角,不是向模型提供平衡點 oracle。
兩種誤差沒有哪一種必然「比較真實」。如果應用關心絕對狀態,原始誤差很重要;如果研究宣稱學到振盪與衰減,動態尺度的誤差便不能被大偏移淹沒。把兩者一起呈現,才能讓讀者判斷模型究竟預測了背景水平,還是預測了真正的變化。
候選池與頻率分離規則都在訓練前固定。56 個合資格系統分成 32 訓練、八個驗證及 16 個完全預留系統。每個訓練系統提供 64 條訓練軌跡及八條獨立 ID 測試軌跡;每個驗證或預留系統提供八條。每條乾淨軌跡在 保存 2,048 個等距點;評估的 context 和未來各有 128 點。
完全預留的系統仍來自相同生成分布。這稱為 held-out system generalisation,不是跨物理定律泛化。稍後 PDE 的參數外推,是另一種預留方式。若把兩者都簡稱 OOD,卻不交代怎樣切分,就會隱藏難度的重要差別。未見過一組矩陣,與未見過另一條物理方程,不是同一項成果。
哪個簡單基線也可以勝出?
Persistence 重複最新觀測;SVD-DMD 直接求解最小平方傳播;ridge-DMD 用驗證選擇的懲罰穩定弱方向;total-DMD 同時處理兩個 snapshot blocks 的誤差,不假裝只有 response 帶噪。解析 GD-DMD 則顯示提早停止迭代的影響。最後,兩個學習型循環版本檢查訓練是否把這些行為改變得更有用。
方法不需要成本完全相同,才值得比較。直接求解器即使不是預期部署方式,仍可作重要參照;但成本必須報告,不能被「循環數」抹平。一個 620 參數 recurrence 的一步,與一次 SVD 是不同運算。訓練成本也要與 inference cost 分開:便宜的每次預測,可能依賴不便宜的準備階段。
經典 noise-aware DMD 工作提供這些控制的理由 [7,8],並沒有保證 total-DMD 必定在這個有限基準勝出。有限資料、正則化、強偏移及數值 rank 都可能改變結果。比較必須容許 persistence 或簡單直接解有競爭力,也必須容許學習模型失敗。
公平不是讓所有方法得到相同漂亮答案,而是讓它們在宣告的信息與調參規則下,各自回答同一個預測問題。如果其中一方可以使用真正平衡點、更多未來觀測,或者按測試誤差選最佳參數,表面上的性能差距便不再只來自方法本身。
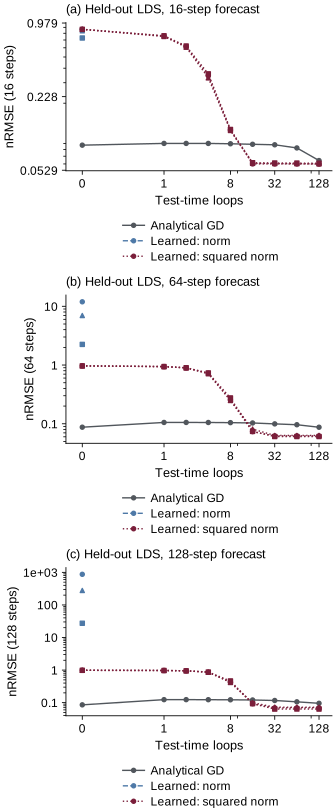
乾淨預留 LDS 在 128 次更新下,平方模型三個 seeds 的中位數為 0.0692118、0.0636388、0.0722670,各涵蓋 128 條成功軌跡;persistence 是 0.0855933。但中心化中位數沒有那麼令人放心:0.881126、0.830133、0.876996。Ridge-DMD 原始中位數為 ,沒有失敗;普通 DMD 的 中位數卻只涵蓋 128 條中的 70 條,另有 58 條失敗。每個原文規則 seed 在這個預算下,128 條預留軌跡全部失敗。準確度若不附分母,會說出另一個故事。
Context 殘差更小,是否代表動力學更正確?
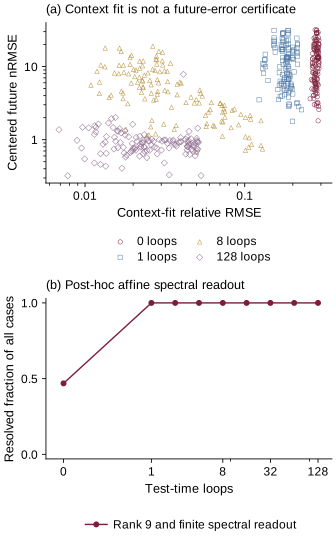
至少有三種不同成果:減少已觀測轉移的殘差、預測未觀測轉移,以及估計動力算子。在條件良好、模型正確而噪聲很小時,它們可以一起進步;在真正令預測困難的問題中,卻未必同步。
為了量度這種差別,本研究記錄 context residual、單步誤差及較長期 nRMSE,並在完成預測後,對產生的物理軌跡另外擬合 affine DMD 算子。這個 spectral readout 是輸出軌跡的事後診斷,不是宣稱從 attention 權重直接取出了唯一內部算子。
診斷使用固定 relative SVD cutoff ,並報告有效 rank。增廣 affine fit 需要足夠秩,才有資訊支持完整頻譜比較。若不夠,便標為 unresolved;不會為了讓 eigenvalue 圖完整,憑空補上缺少的模態。
即使 readout 滿秩,仍要小心。短視窗可能很難分清接近單位圓的 eigenvalues。小小的 eigenvalue discrepancy 不會自動保護所有初值或所有長期 rollout。反過來,模型也可能產生有用的有限期軌跡,而事後算子未能忠實辨識物理機制。誤差圖和頻譜圖回答的是相關、但不相同的問題。
這裏的「辨識」亦不是找一張最像真值的頻譜圖就完成。需要問被辨識的對象是離散時間傳播矩陣,還是連續時間生成矩陣;是否包含常數模態;預測軌跡有沒有激發全部方向。這些條件若沒有交代,數值上接近的點,可以被賦予遠超資料支持的物理解釋。
由八次增至 128 次更新,4,608 對有限 LDS 個案中,有 92 對 context 殘差下降、未來誤差反而上升。AD 的 6,720 對有限個案中有 2,084 對,但全部來自 random initialization,identity 和 pretrained 都沒有這種個案;部分更在零觀測噪聲下發生,因此不能用這些計數證明普遍的「噪聲 overfitting」。它們只是宣告區域的描述性合併,不是獨立統計重複。第一個平方 LDS seed 在 5% 噪聲下,已解析的 rank 九 readouts 從零更新的 60/128 增至 128 更新的 128/128,但滿秩仍沒有保證動力學準確。
當狀態是一個場,問題改變了甚麼?
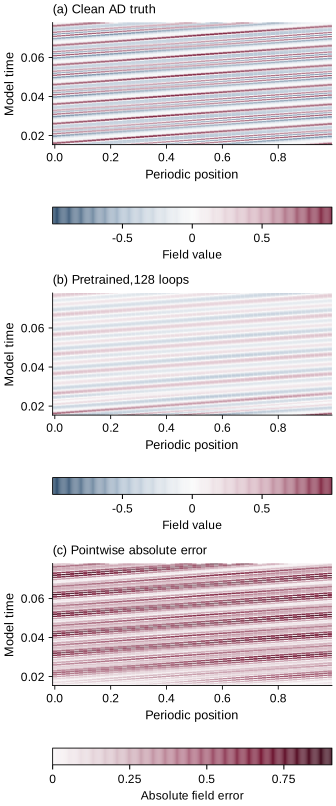
第二個案例是週期場,由下式輸送及平滑:
平流令圖樣移動,擴散削弱細節。在週期域上,Fourier modes 把這兩種作用分開。域長為一、 時,精確採樣傳播為
Multiplier 的 magnitude 描述衰減,phase 描述平移。參照解不需要離散化空間導數,而是直接用 Fourier 公式產生 float64 真值。128、256、512 點的空間網格核對,檢查實作是否尊重 band-limited field,而不是只在某個網格上看似成功。
主網格有 256 點、七個保留 Fourier modes;初始訊號只包含 ,零平均,最大絕對值為一。採樣間距為 、context 32、預測 128 步。這些是本獨立實驗的明確選擇,不是聲稱找回了來源沒有完整交代的設定。
二十組參數沿 、、 排列。前十組為 ID,後十組完全預留作參數外推。每組 ID 有 32 訓練、八驗證、16 測試軌跡;每組預留參數有 16 測試軌跡。速度和擴散率同時改變,因此不能由這條掃描單獨分解兩者的效果。
這個案例容易分析,正因它沒有非線性 mode transfer。初始低頻訊號不會產生新的高頻物理結構。小模型若成功,表示它在這個已知可由少量 multipliers 表達的問題上有效;不等於同樣少量參數已足以解一般流體方程。把簡單案例的優勢說清楚,比用它暗示一個尚未測試的普遍能力更有說服力。
為甚麼這麼小的 Fourier 模型仍值得研究?
七模態 adapter 可以很小,是因參照方程在 Fourier 空間中對角化。它不是發現一個通用非線性 PDE solver。局部 scalar connection 與 complex spectral weights 組成有效 multipliers:
Encoder 和 decoder 固定為一。七個 complex weights 加一個 real local weight,共有 15 個實數量交給 optimizer;再加兩個固定 scalar maps,儲存量是 17。兩個數字都不是可辨識物理自由度的數目。Real inverse transform 看不到所有儲存的 complex components,只有帶訊號的 modes 才能限制相應 multiplier。
對乾淨 band-limited 輸入,模型還有 gauge ambiguity:把同一個實數加到 local connection,再從每個保留 spectral weight 減去它,保留模態的有效 multipliers 不變。但未保留模態的 gain 會改變,因此這不是整個 full-spectrum operator、亦不一定是帶噪資料的不變性。即使在精確算術,把個別權重當獨立物理參數仍會誤導。較有物理意義的對象,是激發模態上的 combined multiplier;之後仍要問,其 phase 是否足以唯一決定速度。
Fourier least squares 提供直接參照。對觀測 power 非零的 mode,可以由成對 Fourier coefficients 求出最佳 complex multiplier。Parseval 恆等式把 spectral residual 連到 spatial squared residual,前提是 transform normalization 和 one-sided weighting 一致。獨立的頻域/空間損失核對,可以防止正頻率配對少算一個因子,從而悄悄改變整個適應問題。
直接 optimum 仍不能消除 noisy-input bias。帶噪 coefficient 同時出現在 regressor 和 successor relation 中,所以更小殘差仍可能對應更差的乾淨 multiplier。直接解的用途,是分清「最佳化還未完成」,以及最佳化完成後仍然存在的資料或目標限制;不是宣布算出最小平方答案,科學問題就已全部解決。
未被激發的 mode 亦值得保留在解釋中。如果初值在某 mode 沒有能量,該 mode 的 multiplier 對軌跡就沒有可觀測作用。模型可以在該方向保留初始化,並保持漂亮預測。這不是獲得了額外物理知識,而是預測任務暫時不需要該方向。參數恢復報告應排除或標示這些情況,不能把沒有訊號誤寫成恢復失敗率為零。
預訓練為適應提供了甚麼?
Identity、random、pretrained 三種初始化,在主比較中使用相同 inner AdamW:learning rate 0.01、betas 、weight decay 零。原文為 random initialization 使用的不同 preset,只保留為另列診斷。否則所謂初始化優勢,可能其實是 optimizer hyperparameters 的優勢。
預訓練學的是起點,不是替每個測試個案預先知道 PDE 參數。三個 seeds 各執行 3,000 outer steps,每個 batch 由同一系統的八條軌跡組成,共用一套 fast weights 適應。評估時卻只有一條軌跡,而且每個獨立測試都重新載入初始化、清空 optimizer moments。若跨個案保留 moments,便加入了一條沒有宣告的額外資訊流。
Inner loss 是 context 上平均 space–time MSE;outer loss 是下一步誤差。計算對完整 AdamW 適應過程微分,包括 moment state,不把學習中的初始化 detach,也不截斷 meta-gradient。獨立 finite-difference 和 automatic-differentiation controls 核對這條路徑。梯度正確,只建立「確實在最佳化這個目標」,沒有保證學得的初始化一定有益。
這種內外層目標差別,正是研究有趣的地方。Inner loop 只能使用現在已知的轉移;outer training 則利用訓練資料中的下一步答案,教初始化如何讓有限適應更有用。但如果測試分布不同、噪聲結構改變,訓練時有用的起點未必仍合適。不能單靠「曾經預訓練」四個字,跳過主比較。
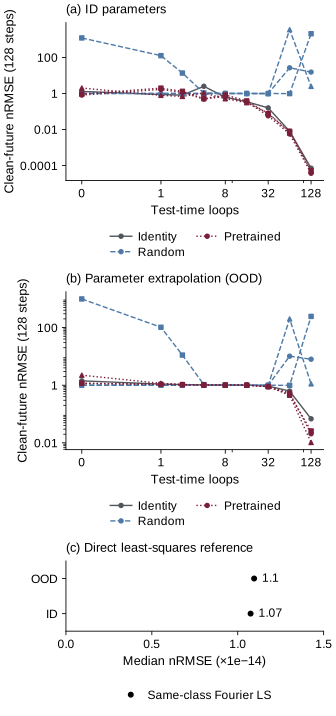
在 128 次更新下,每個乾淨參數外推的初始化/seed 摘要,都有 160 條成功有限軌跡。Identity 的 128 步 nRMSE 中位數為 0.0683804;三個 pretrained seeds 分別為 0.0207394、0.0258472、0.0103202。相對 identity,預訓練改善了這些中位數,但同模型類別的直接 Fourier 最小平方中位數是 。在這個乾淨、模型正確的例子,直接擬合仍是比只比較學習初始化更強的參照。
中位數改善,不等於所有預測都準。Pretrained seeds 的實際第 75 百分位誤差為 0.527004、0.491229、0.482726,描述 160 條軌跡之間的分散,不是信賴區間。因此固定極端參數說明圖,應與中位數一起讀;只給典型數字,會隱藏不少很差的預測。
同一主要 preset 下,random initialization 的中位數為 7.9693、244.0531、1.1153。每個 seed 的 160 條軌跡,都仍低於宣告的一百萬相對 blowup 失敗門檻。它們是很差但有限的預測,不是數值失敗。如果把它們當失敗丟掉,就會刪去重要負面結果。這些數值描述本小型研究,不是對原作者不同 random preset 或訓練程序的受控否定。
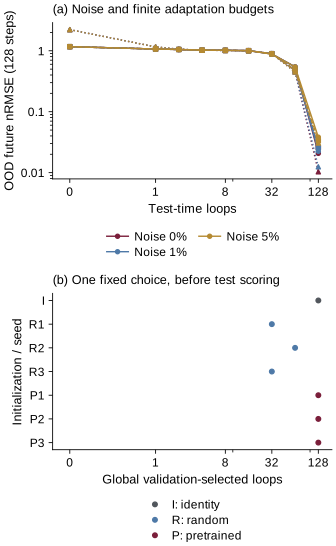
噪聲如何改變停止問題?
觀測噪聲為訓練 context fluctuation RMS 的 0%、1%、5%,不是整個狀態或場大小的百分比。每條訓練軌跡先減去自己的 context 時間平均:LDS 逐通道計尺度,AD 則先逐空間位置中心化再聚合。不使用真實平衡點決定噪聲。每個方法收到相同 realization。這種配對讓方法差別較容易解釋,卻不會增加獨立重複數;尤其數千個評分時間點,不是數千次獨立模型訓練。
早期迭代可以形成 implicit regularization:充分激發的方向先移動,資訊薄弱方向較慢。較後迭代可能改善乾淨預測,也可能開始擬合不能預示乾淨未來的誤差。兩種方向都不預設。Noise-aware DMD、ridge regularization 和 early stopping,是不同回應方式;配對比較可以看出它們的效果在哪裏重疊、在哪裏不同。
停止規則若由驗證資料選擇,不需要測試標籤就能使用。看過測試未來後才挑最好的 iteration,卻是另一回事。那條 oracle curve 可以診斷尚有多少改善空間,但不是可部署預測器。本文分開這兩個類別,不把事後最佳點包裝成在線決策的成果。
這也限制了「最佳循環數」的用語。它可能是某個噪聲水平、某個預測期和某組系統的驗證選擇,不是一個放諸所有情境皆準的常數。若短期誤差與長期誤差偏好不同停止點,便需要先交代部署目標。否則研究者可以在不同圖上選不同的最佳答案,讓方法看起來總是贏。
在 5% fluctuation-RMS 觀測噪聲及 128 次更新下,identity 的預留中位數增至 0.0796871,三個 pretrained 中位數為 0.0381882、0.0334018、0.0306020;各自同樣包含 160 條成功有限軌跡。同類最小平方為 0.0183728。乾淨資料接近 roundoff 的結果,不再意味帶噪預測也能接近 roundoff:把可用觀測擬合好,不能恢復被污染抹去的資訊。
全局驗證規則為 identity 及三個 pretrained seeds 選擇 128 次更新,random seeds 則為 32、64、32。這些選擇在所有宣告噪聲水平共用,不按每個測試區域各自調整。上面 random 的 128 次比較是固定預算診斷,不是這些驗證選擇政策;沒有把看過測試答案才選的最佳點,當成可用停止規則。
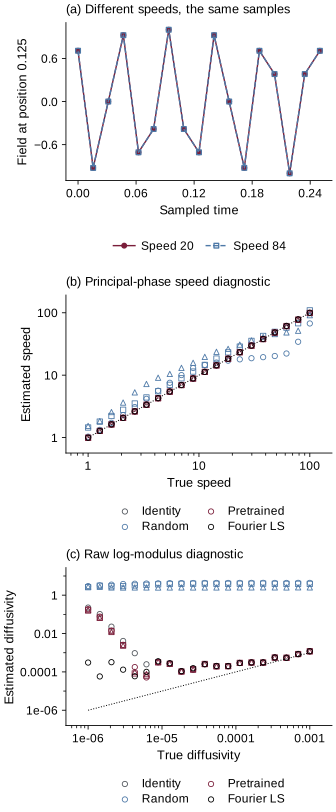
完美預測,仍可能辨識錯速度嗎?
對 magnitude 非零的 Fourier multiplier,可以嘗試由下式估計速度與擴散率:
第二式使用 magnitude,第一式卻使用只按一圈回報的角度。Phase 不自動等於已 unwrap 的物理位移。快速圖樣可以在週期域繞了一圈,在採樣時刻看起來卻與較慢圖樣一樣。
一個精確控制不需要最佳化,便能看見問題。固定初值與擴散率,設 ,比較速度 20 和 84。兩者的速度差,令圖樣在相鄰觀測間剛好多走一個完整域長。對每個整數 mode,
所以兩個 sampled propagators 完全相同。場在觀測之間可以不同,但任何只使用這些樣本的算法,都不能區分兩個速度。更多適應、更好的初始化或更低訓練殘差,都不能補出缺少的時間資訊。
這個控制不是主實驗的採樣區域,也沒有證明主實驗的速度必然錯。它展示物理參數解讀需要的額外假設。更密採樣或有依據的速度範圍,可以排除歧義;再有信心的 multiplier fit 本身卻不可以。即使模型類別精確包含真實採樣傳播,預測與辨識仍是兩種成果。
此外,擴散率的 magnitude 解讀也需要檢查訊號強度。當某 mode 已衰減得很小,量測噪聲會主導其 coefficient;對近零 magnitude 取對數,可能放大相對誤差。這不表示 phase 問題與 magnitude 問題一樣,而是提醒我們:把有效 multiplier 轉成物理參數,是另一層 inverse problem,不應在畫出漂亮預測後自動宣布完成。
多一步計算,值得多少?
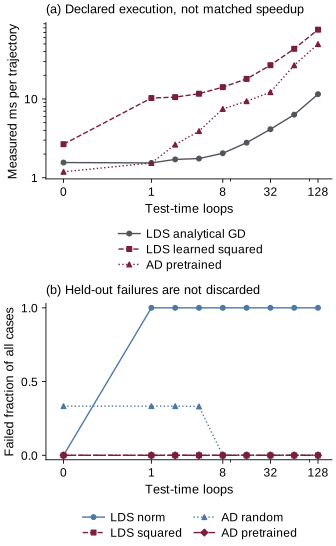
適應曲線應與成本和失敗曲線一起閱讀。如果 128 次迭代換來少量準確度,在有時間的推論情境可能值得;若直接求解器更快達到要求,同一方法便未必適合。偶爾發散的模型,也不能只用成功完成的漂亮預測評價。
本研究分開記錄實際適應工作與訓練工作。獨立測試每次重設狀態,timing 不要求 bit-for-bit 相同。兩次正式運算經四個單執行緒 family workers,在同一 CPU 並行;時間衡量這次研究的實際工作,不是乾淨、隔離的推論 latency 基準。科學輸出以同一 source 和設定比較,runtime 另存,不把科學一致誇大成跨硬件加速比或 latency 保證。
非有限值及大的 relative blowups 按失敗類別保留,不會把預測 clipping 回合理振幅,也不會悄悄把 eigenvalues 投影到穩定區域。這些修補可以是合理的另一種方法,但會改變本研究的問題。因此有限個案的準確度摘要需要交代分母,並與失敗數一起呈現。
兩個案例使用不同尺度的診斷旗標。LDS 把非有限預測,或任何一步八通道 RMS 超過已觀測 context RMS 一百萬倍,標為失敗。AD 則檢查非有限預測/gains,或預測的逐點最大絕對值超過乾淨未來 RMS 一百萬倍。AD 由真值計算的尺度只供評分,不會進入適應。這些 cutoff 不是物理安全標準;跨案例失敗比例不是相同正規化的風險,低於 cutoff 也不代表準確度有用。
讀成本圖時也要注意攤銷方式。如果同一模型會預測很多條軌跡,預訓練成本可分攤;如果只解一次小問題,直接最小平方可能更合適。本文報告各項工作,而不把某一種使用頻率當作普遍標準。計算換準確度的答案,需要先知道誰付準備成本、誰付每次推論成本,以及容許多少失敗。
兩輪完整運算的科學輸出一致。LDS 表保留 77,184 筆方法–預算紀錄,其中 28,761 筆失敗;AD 有 62,400 筆,其中 2,558 筆失敗。這些是相關評估紀錄,不是獨立試驗。每次共用 CPU 運算約需 23.3 分鐘。獨立實作的 GD/attention iterates 最大差異為 ;這些實作核對支持比較可靠性,不構成學習模型準確度保證。
這個比較能決定甚麼,不能決定甚麼?
兩個案例刻意揭示機制,不是覆蓋整個預測世界。穩定 affine 系統沒有測試 chaos、改變中的物理規律或隱藏輸入;對角線性 Fourier 方程沒有測試非線性 mode transfer。相關 PDE 參數掃描適合受控外推,卻不能建立每個物理係數獨立改變時的穩健性。
每個學習設定只有三個訓練 seeds。它們的差異應該展示,不應埋進一個把全部軌跡當獨立模型重複的 pooled standard error。有限系統集合支持的是基準比較,不是對未知部署環境的母體可靠性估計。即使總評分數很多,真正獨立訓練的模型仍只有宣告的那幾個。
最強的精確結論,關乎指定二次更新,以及指定採樣反例。學習模型的比較是固定 protocol 下的數值證據。梯度測試通過、參數數量相符、兩輪輸出一致,支持實作可靠性,卻不等於 generalization theorem。保留這些分別,才能讓不理想的學習結果仍有研究價值,不必被更強故事掩蓋。
Test-time training 本身是既有背景 [9]。實際問題是適應可以最佳化甚麼、可用資訊如何連到預測目標,以及何時值得付成本。在模型正確、乾淨而條件良好的回歸中,更多工作能減少真正數值誤差;在帶噪或不可辨識問題中,最佳化可以完成,科學上重要的不確定性卻仍未解。
這種區分也改變了下一個實驗應該怎樣設計。如果主要限制是慢收斂,改良 preconditioner 或停止規則值得研究;如果限制是缺乏激發方向,多算同一批資料未必有幫助,應改變觀測或初始條件;如果限制是採樣混疊,便需要時間解析度或額外物理範圍。不同失敗原因對應不同補救,不能全部交給「再加幾次循環」。
結論
更多計算在特定設定有用,卻不能取代合適目標、初始化或觀測設計。已驗證研究支持有界線的比較,並保留負面結果;它不宣稱新預測原理,也不是原論文的定量重現。
這些結果強化了一個核心分別:擬合已觀測 context、預測乾淨未來、辨識物理規律,並不是可以互換的成果。更多 test-time computation 直接改變第一項;能否改善其餘兩項,取決於目標、觀測、模型類別,以及 context 真正承載的資訊。
在要求預測模型「再想久一點」之前,先問它下一步正在解甚麼。殘差仍告訴它有關動力學的訊息嗎?Context 可以區分正在報告的參數嗎?停止點有沒有偷看答案?這些問題,讓一條平滑的「更多計算」曲線,變成可以解釋、可以反駁、也可以繼續改善的研究結果。
可參閱專案概覽,了解兩案例設計與這次獨立研究的解讀界線。
參考文獻
- Lai、Quinn、Bao 與 Gilpin.Test-Time Forecasting: Recurrent Depth Enables In-Context Dynamics Prediction(2026),v1。原始預印本。
- Schmid.Dynamic mode decomposition of numerical and experimental data(2010)。正式論文。
- Tu、Rowley、Luchtenburg、Brunton 與 Kutz.On Dynamic Mode Decomposition: Theory and Applications(2014)。正式論文。
- Williams、Kevrekidis 與 Rowley.A Data-Driven Approximation of the Koopman Operator: Extending Dynamic Mode Decomposition(2015)。正式論文。
- Korda 與 Mezić.On Convergence of Extended Dynamic Mode Decomposition to the Koopman Operator(2018)。正式論文。
- von Oswald 等.Transformers Learn In-Context by Gradient Descent(2023)。原始會議論文。
- Hemati、Rowley、Deem 與 Cattafesta.De-Biasing the Dynamic Mode Decomposition for Applied Koopman Spectral Analysis(2015 預印本、2017 期刊)。原始預印本。
- Dawson、Hemati、Williams 與 Rowley.Characterizing and correcting for the effect of sensor noise in the dynamic mode decomposition(2016)。正式論文。
- Sun 等.Test-Time Training with Self-Supervision for Generalization under Distribution Shifts(2020)。原始會議論文。
- Li 等.Fourier Neural Operator for Parametric Partial Differential Equations(2021)。原始預印本。