更多計算,不是更多觀測
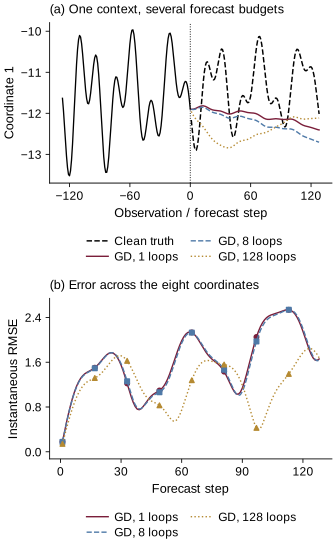
模型可以在 inference 期間多花時間,用眼前軌跡更新預測規則,但這不等於收到新量測。這個專案問:若 context fit 改善,有沒有轉移到未見的乾淨未來?同一批證據,是否也足以支持附在預測上的物理解釋?
研究依據 Lai 等人 Test-Time Forecasting v1 的部分公式,是小規模獨立重實作,不宣稱重現完整原始實驗。DMD、attention/梯度下降及 Fourier operators 的既有背景獲明確引用,不包裝成新的學習原理。
兩個受控案例
第一個案例重建 620 參數循環 linear-attention 模型,處理穩定八維 affine 系統。56 個合資格系統分成 32 訓練、八驗證、16 完全預留系統。直接解、正則化、total-DMD 及解析迭代基線,分清結果來自學習型 recurrence,還是求解 context 回歸本身。原文規則正規化和平方 norm 版本分開保留。
第二個案例使用解析傳播的週期平流–擴散場,讓七模態 Fourier adapter 從 identity、random、pretrained 初始化出發,使用相同主要 inner optimizer 設定比較。17 個儲存實數量包含兩個固定 scalar maps,15 個量進入最佳化;真正可辨識的物理組合更少。直接 Fourier 最小平方參照,分清未完成最佳化與資訊不足。
各方法共用觀測,對乾淨未來評分。1% 和 5% 噪聲指減去 context 時間平均後的訓練波動 RMS,不是整個場大小。調參只使用驗證資料;三個訓練 seeds 分開呈現,不把時間點或同一模型下的大量軌跡當成獨立訓練重複。
預測不自動等於辨識
精確回歸控制說明,平方 norm 步長條件和零空間初始化不能忽略。另一個週期採樣控制,在間距 1/64 比較速度 20 與 84:兩者連續運動不同,採樣 Fourier propagators 卻完全相同。即使採樣預測非常好,也不能補出觀測本來沒有的區分資訊。
兩輪完整運算的科學輸出相同。由八次比較至 128 次更新,4,608 對有限 LDS 中有 92 對、6,720 對有限 AD 中有 2,084 對 context 擬合改善、未來預測反而變差。AD 這類個案全部來自 random initialization,不是 identity 或 pretrained,部分更在零觀測噪聲發生;不能稱為普遍噪聲 overfitting。完整表保留 77,184 筆 LDS 和 62,400 筆 AD 紀錄,分別有 28,761 和 2,558 筆失敗;這些相關紀錄不是獨立重複。
貢獻定位為有界線的合成比較與機制解說,不建立天氣、工程量測或任意 Transformer 的準確度保證。較小 AdamW 訓練運算,亦不能單獨確認或推翻原作者使用 SOAP 的研究。
閱讀《多算幾步,就會預測得更準嗎?》,了解推導、十幅研究圖、配對比較,以及擬合、預測與動力學辨識的分別。
主要結果
- 採樣間距為 1/64 時,速度 20 與 84 的週期場可以具有相同採樣傳播。
- 128 次更新的平方 LDS 模型,乾淨預留中位誤差為 0.0692118、0.0636388、0.0722670,各有 128 條成功軌跡;原文規則每個 seed 的 128 條全部失敗。
- 乾淨預留 Fourier 預測在 128 次更新下,pretrained seeds 中位誤差為 0.0207394、0.0258472、0.0103202,identity 為 0.0683804;每摘要包含 160 條成功有限軌跡。
- 同類 Fourier 最小平方的乾淨預留中位誤差為 1.0954e-14,百分之五噪聲下為 0.0183728;直接擬合仍是強參照。
- 4,608 對有限 LDS 中有 92 對、6,720 對 AD 中有 2,084 對擬合改善而預測變差;AD 這類個案全來自 random 初始化,不是 identity 或 pretrained。
限制
- 這是小規模獨立重實作,不是完整重現原作者的數值研究。
- 三個訓練 seeds 及較小 AdamW 預算,不支持母體性能估計或對來源方法作普遍判斷。
- 預留線性系統共用生成規則;PDE 參數掃描同時改變速度與擴散率。
- Context 擬合、未來準確度與唯一物理辨識,仍是不同成果。