想像把少量染料注入一組互相連接的水槽。出口附近裝有感測器:如果未來幾小時內有太多物質積聚,就發出警報。現在有兩個管道設計,注入的總量相同、各處移除物質的速率相同,連模型的整組特徵值也完全相同。長期穩定性檢查給出同一個答案。感測器是否也應該給出同一個答案?
未必。物質走哪一條路,決定它何時到達感測器;而移除過程一直沒有停止。短路徑可能讓很多物質及早到達,足以跨過門檻。較長路徑可能把到達時間攤開,讓更多物質在途中被移除。兩個網絡最後都會清空,但「最後都會清空」並沒有回答「接下來幾小時會否超標」。
這是一個假想的運輸實驗,不是經過校準的污染風險評估。狀態變數表示理想化區室中的非負物質量;警報門檻是預先指定的模型設定,不是法規標準。數學反例可以有啟發性,卻不需要假裝已經知道真實環境監測應採取甚麼行動。
背後的數學也不是新發現。Phase-type 分布研究物質通過 Markov 階段的時間;正值系統分析保留非負性與物質收支;nonnormal dynamics 說明特徵值為何不能概括所有暫態。Bao 等人的近期工作更直接把局部輸入、網絡暫態與有向遊走連起來 [1–4]。這裡的問題較窄:當路由改變,但物理帳目保持一致,哪些計算真正足以回答一個指定的有限時間警報?
Nazerian 等人在 2026 年把網絡作為開放系統研究,同樣明確處理輸入與輸出節點,使用頻率響應及 範數 [5]。本文不是再問網絡結構會否影響轉移,而是問:指定物質量峰值,會否在期限前超過預設門檻,以及界限能否在公平路由改變下認證這個答案。不同績效量不能互相冒充。
預留比較的 6,912 筆配對門檻查詢中,有 172 筆警報改變,6,740 筆保持不變。路徑特定包絡認證了 6,473 筆不變決策,基本範數上界則認證 3,147 筆。這是受控的合成研究結果,不是新的暫態理論,也不是現實警報普遍性的估計。
感測器問的問題,不是穩定性問的問題
特徵值描述線性系統的一組指數速率。對所有特徵值實部均為負的自治模型,擾動最終會衰減。這是重要結論:模型不會持續指數增長。但它沒有交代一次局部釋放,會有多少物質在衰減成為主導之前,流到某一個指定區室。
門檻監測需要三個額外選擇:輸入在哪裏、輸出量甚麼,以及觀察多久。這裡的輸入是來源區室的一單位釋放;輸出是感測區室當時存有的物質量;觀察在固定期限結束。改變其中任何一項,都可能改變警報,卻不需要改變矩陣的特徵值。
設物質量向量為 ,每個分量對應一個區室。我們採用「以欄為來源」的記法:非對角元素 表示物質由區室 轉移至區室 的速率。每個區室總共轉走多少,就在該欄的對角項扣回多少;另外,各處都以相同速率 移除物質:
非對角元素非負,使 和 都是 Metzler 矩陣:由非負物質量出發,矩陣指數不會產生負物質。每欄總和為零,則表示轉移只重新分配物質,沒有憑空創造或消滅物質。加上統一移除後,總量有一條精確收支式,而不是事後「看起來差不多守恆」的數值檢查:
如果初始總量是一,時刻 的總存活量就是 。任何一個區室的量都不能超過這個總數。不過,其他區室正在減少時,終端區室仍可以正在增加。感測器讀數上升,不等於總物質增長,也不一定是數值不穩定;它可以只是正在衰減的系統內部,物質重新分配的正常結果。
這個限制讓研究與任意矩陣的放大例子有清楚分別。如果可以任意選擇非對角符號或欄總和,很容易靠不符合運輸意義的方程製造大響應。這裡不能用那些捷徑:物質始終非負,總量始終遵守同一收支。值得解釋的是,在這些物理限制之下,警報差異仍然存在。
用 表示在來源 注入一單位,用 選出感測區室 。來源至感測器的響應,以及期限內的峰值,分別為
警報定義為 。嚴格大於是定義的一部分:剛好碰到門檻,不會悄悄改算成超越。若計算誤差還分不清真峰值在門檻哪一邊,就應保留未能判定,而不是把四捨五入後的一個正負號當成確定答案。
路線變了,整組特徵值仍可以不變
概念導讀 · 假設
建立模型或推論時採用的條件;結論取決於相關條件是否成立。
本文例子:配對網絡構造採用無環路由、暫態節點相同的總轉移率,以及均勻移除。
常見誤解:假設合理,就等於已經觀察證實。
適用範圍:這些限制屬於該網絡構造;其他模型與方法需要各自的假設,沒有一份清單適用於所有分析。
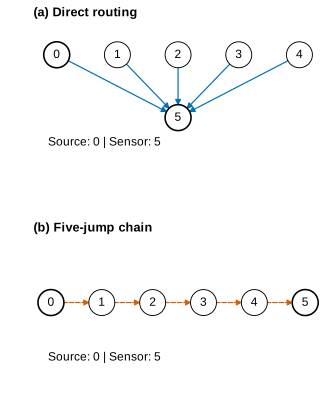
考慮六個由來源排至終端的區室。所有連線都只指向排序較後的位置,因此沒有有向循環。前五個區室各自以總速率 把物質向後轉移;最後一個區室沒有轉移出口,但仍以相同的 移除物質。路由機率只決定每次轉移要送往哪個較後區室。
這樣建立的生成矩陣是下三角矩陣。它的對角線永遠有五個 和一個 。三角矩陣的特徵值就是對角項,因此任何容許的路由機率變化,都保持整組特徵值相同,而不只是保持最大實部相同:
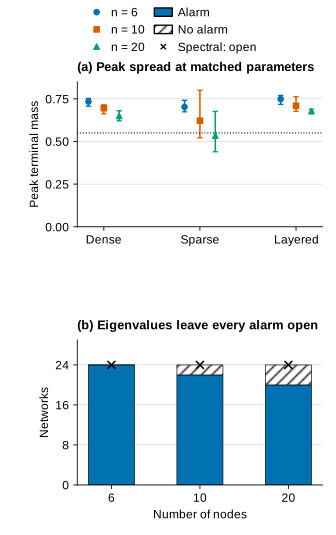
這讓「只看特徵值」的資訊限制很乾淨。同一族網絡的頻譜沒有任何路由資訊可以用來區分設計。若一個確定性的篩選規則只接收特徵值與共同監測設定,它就必須對所有成員給出相同答案。一旦有兩個有效路由產生相反警報,這種規則就不能同時分對兩者。問題不是還未找到夠聰明的頻譜門檻,而是輸入資訊根本沒有包含差別。因此比較中的特徵值方法只報告漸近穩定,對警報棄權;我們不替它編造二元預測。
兩個極端路由容易看出原因。直接設計把來源物質一步送到終端;鏈式設計則需要連續完成五次轉移。每次轉移的等待時間都是速率 的指數分布。直接旅程只有一個等待階段,鏈式旅程有五個。相同的局部離開速率,不會把不同階段數的首次到達時間變成相同。
這個例子刻意簡單。它用來核對矩陣方向、物質帳目及封閉形式,並讓機制變得可見。它不是新定理,也不足以證明一套新網絡分析方法。更有價值的比較必須離開這一對極端例子,保留物理上的公平條件,再問其他預留路由結構是否仍出現同一類差異。
還要留意:相同特徵值不等於相同特徵向量、Jordan 結構或 transfer function。重複特徵值可以伴隨乘在指數前的時間多項式,描述訊號逐步傳播的延遲。因此不能把這裡說成「所有動力學相同,只有一個神秘暫態例外」。真正相同的是一組頻譜速率,不是完整的時間演化映射。
Nonnormality 是重要背景,但不是這個構造唯一被隔離的原因。當矩陣不與其轉置交換,就稱為 nonnormal;網絡的結構性 nonnormality 已有深入研究 [9]。交換子範數可以量化這個性質,卻沒有記住哪裏釋放、哪裏觀測。兩個診斷值接近的網絡,仍可能有不同來源至感測器響應;診斷值改變,也不會直接告訴我們是哪條路造成超標。所以這裡保留它作結構診斷,不把它當成經校準的風險分數。
跟住物質走,可以得到另一個精確答案
同一個模型有機率上的解讀。跟住一個代表性物質單位:它在非終端區室等待速率 的指數時鐘,然後按照路由機率選擇下一個區室;另一個獨立、速率 的移除時鐘,則可以在任何位置把它消除。因為模型線性,很多單位的機率分布就對應區室中的物質量。
假設到達終端前剛好要完成 次轉移。條件在這個階段數之下,旅行時間是 個獨立指數等待時間之和,也就是 Erlang 分布,一種經典的 phase-type 分布。它的累積分布函數為
這個函數描述未考慮移除前,物質在時間 之前已經到達的機率,不是到達密度。終端收到物質後,除了統一移除之外不會再把它送走,因此 階段路徑的終端物質量是 。存活因子包含整段已經過去的時間,也包括到達後留在終端的時間。
對一般向前路由,令 表示 embedded jump chain 剛好經 次轉移首次到達終端的機率。計算時可以每次推進一跳,把到達終端的機率取出,不再讓它繼續被當作新到達。終端的精確響應就是
在這個無環、相同等待率的模型中,有限加總是精確表示,不是擬合,也不是 Monte Carlo 形成的包絡。矩陣指數與路徑公式用不同計算方式描述同一動力學,因此適合互相核對。核對應報告宣告時間點上的誤差,而不只是兩條線「看起來重合」。
目前所有非終端節點都指向較後節點,唯一終端就是感測器,所以不計移除時最終到達機率為一。更一般的網絡可能有其他出口,路徑權重總和未必為一。如果強行把它們重新正規化,就等於條件在「最後成功到達」之下再計算,會高估無條件的感測器物質量。這不是修飾數字,而是換了一個問題。
相同等待率也不是可有可無的便利。若不同區室有不同離開速率,只知道轉移次數就不足以決定 Erlang 分布,還要知道實際經過哪些速率。若有循環,遊走可以任意長,這個短的有限加總也不再適用。一般 phase-type 工具仍能處理許多情況,但不能把本文的簡式不加修改地搬過去 [2,3]。
這種機率解讀還幫助分清兩個看似相近的量。「曾經到達」與「現在還在」不同。沒有移除時,吸收終端的累積到達機率單調上升;有移除時,終端物質量先上升後下降完全合理。若把累積到達率當作當前庫存,便會把晚期響應與峰值的意義都改掉。
為甚麼較長路徑可能避過早期警報?
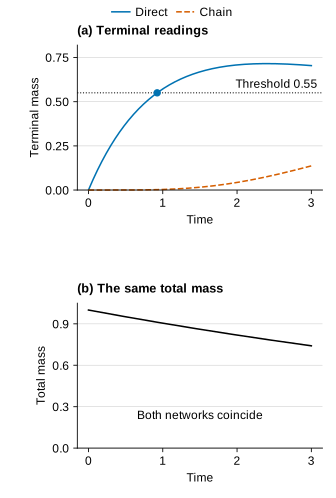
直接路由與鏈式路由的不同,集中在到達時間分布。直接路徑把較多機率放在早期;較長路徑則要等多個階段完成,讓到達變遲、變分散。在此同時,統一移除持續減少存活物質。因此峰值由到達與損失的競爭決定,不是單看一個衰減特徵值就知道。
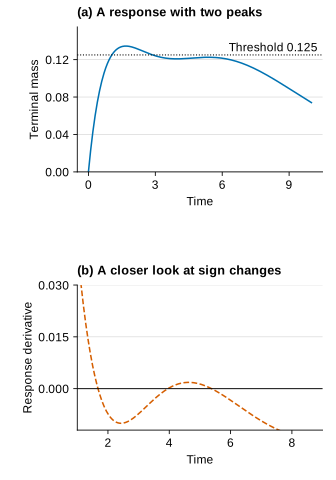
對一步路徑,把 微分,可以得到不限制期限的峰值時間 。如果這個時間超過觀察期限,期限內最大值就在右端點。這個小分別很重要:總有一天的最大值,與未來三個時間單位內的最大值,不是同一個決策量。
對多階段混合,短路徑與長路徑分量可以影響曲線不同部分。平均路徑長度有助直覺,卻不能決定整條響應。兩個混合分布可以有同一平均數,一個把機率集中在中間,另一個把較多機率放在很短與很長的兩端。早期門檻對很短路徑的少量權重,可能特別敏感。
較遲到達也不代表設計必然較好。它可能避開第一個監測窗,卻進入第二個監測窗;換一個感測位置,原本隱藏的路線可能直接經過感測器;降低門檻,兩個網絡可能都發出警報。這些不是機制失效,而是提醒我們,必須先定義要回答哪一個監測問題。
所以,每次等頻譜比較都固定來源、感測器、注入量、移除與轉移速率。如果某個設計本來就注入較少物質,或漏失較快,它的低峰值不需要路由來解釋。受控反例先排除這些捷徑,再測其他結構與參數,而不是只選最戲劇化的一對網絡。
這裡的「等頻譜」亦有精確範圍。同一比較對之內,兩個矩陣有同一組特徵值;若整個參數掃描改變了 或 ,共同特徵值也會跟着改變。把所有掃描情況一概說成同一個固定頻譜,會抹去參數本身的作用。
可靠比較不止要一條平滑曲線
說矩陣指數是精確解,指的是數學表示。電腦求值仍有浮點誤差;同樣,有封閉公式也不會令時間網格上的峰值,自動成為連續時間精確峰值。尖峰可能在兩個採樣點之間;局部求解器找到一個駐點,也不等於已證明沒有其他更高的峰。
驗證因此分成三件事。先核對生成矩陣的符號、欄總和、對角頻譜和共同輸入輸出;再比較獨立計算的響應;最後控制時間最大化與門檻分類。第二件事做對,不能代替第三件事。兩套程式在同一批採樣點重合,仍可能一起漏掉採樣點之間的最大值。
如果函數值本身有可靠包圍,時間網格可以給峰值下界:真峰值不可能比所有採樣值都小。要有上界,還要控制採樣點之間的變化。導數界限可以限制變化幅度;區間細化則把計算集中在仍可能藏有更高值的時間小格。上下界的價值,正是把尚未知道的部分明確留下。
當峰值下界已高於門檻,可以驗證警報;當上界不高於門檻,可以驗證沒有警報。若門檻仍夾在包圍內,就先保留未能判定,再按既定資源與精度細化。這個三值判斷不會把數值捨入的方向,冒充成研究結論。
首次跨越時間還需要額外處理。若初值在門檻下、響應連續,而峰值已驗證在門檻上,就知道存在跨越;但未知道最早何時跨越。稀疏的符號變化搜尋,可能漏掉更早的短暫超越或接觸。時間應附有效的驗證方法與區間,否則只能稱為數值診斷,不能稱為已認證的最早事件。
嚴格控制還需要說明「精確」是相對哪個模型。電腦中的路由小數可以被視為已凍結的有理數,再對這個量化模型作向外捨入的區間計算。這證明的是宣告係數模型的數學結果,不會順便消除真實參數的量測誤差。係數表示誤差與物理模型誤差,是兩種不同的不確定性。
完整評估把全部 2,880 個連續時間峰值,以及 2,304 個最大響應差,包圍至寬度不超過 。存在首次跨越時,時間範圍寬度不超過 ;正式門檻決策與跨越檢查均沒有未定個案。獨立矩陣指數核對的最大差異為 。路由係數先量化,再作為指定模型的精確數值處理。兩次完整運算的科學記錄一致。另有刻意貼近峰值的控制耗盡細分預算,保留為未定;它與正式基準分開,不會暗中加入或刪除。
界限回答的問題,與預測不同
概念導讀 · 穩健性
情況按指定方式改變後,某個結果或表現能維持到甚麼程度。
本文例子:比較兩個符合假設的路由時,若有效響應差界限小於名義決策裕量,便可證明兩者警報相同。
常見誤解:證書未能判定就代表失敗;對一種擾動穩健就涵蓋所有擾動。
適用範圍:此保證只適用於指定模型假設下所比較的一對路由;要涵蓋整個路由族,需有對該指定族一致成立的界限。
假設名義路由矩陣為 ,修訂後或不確定的路由為 。對兩者都算精確響應,可以知道這一對網絡是否有不同警報。穩健性界限問的是另一個問題:名義峰值離門檻是否夠遠,讓宣告大小的擾動無法改變決策?
起點是 Duhamel 恆等式。正值系統及 Markov 鏈擾動分析已有成熟理論 [6–8];以下只是把它們用於指定來源、感測器與期限:
恆等式本身不需要運輸解讀。真正有用的簡化來自物理限制:兩個生成矩陣的欄總和同為 ,所以其非負傳播矩陣的欄總和及誘導一範數,都恰好等於 。每欄描述由一個單位釋放得到的存活分布。
在積分內使用誘導範數,就得到任何共同來源與感測器的響應差界限。兩段傳播的存活因子,在整個積分區間都相乘成 ,因此
在固定期限內,右方於 取最大值。峰值差不超過整段時間的響應差上界,所以
兩條曲線的峰值不需要發生在同一時刻。因為每一個時刻的差都不超過同一上界,把第一條曲線的最大化時間代入第二條,得到一個方向的不等式;再交換兩者,便得到另一方向。這個論證沒有偷偷假設峰值時間不變。
名義決策 margin 是峰值到門檻的距離。如果距離比有效擾動界限大,修訂後峰值就不可能跨到另一邊:
這是單向推論。不滿足不等式,不代表警報會改變,只代表這個證書未能回答。精確比較可能仍顯示兩者相同,也可能由更緊的界限認證。若把「證書不知道」寫成「系統危險」,整個分析便會系統性地誤導讀者。
數值包圍亦要放進 margin,而不是只比較四捨五入的峰值。當名義峰值只有一段區間,能使用的距離應取離門檻最近的可靠一側;界限自己若有區間誤差,也應取保守上端。這樣得到的結論較少,卻不會把尚未控制的數字誤差藏在嚴格不等式裏。
不等式是真的,也可能沒有實際用途
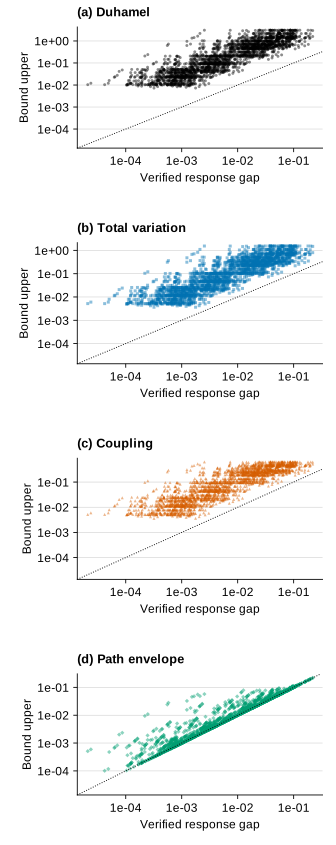
誘導一範數界限刻意一般。它為改變最大的那一欄付出代價,不論物質是否及時到達那裏;之後又容許下游影響以對感測器最不利的方式貢獻。這些放寬讓證明有效,同時丟掉很多路由幾何資訊。
因此,界限可以遠大於實際峰值差,甚至大於物理上可能的最大差。這不令證明變錯,只代表界限很鬆。用物質量的平凡範圍截緊上界,可以改善數字,卻不能憑空補回足以判定貼近門檻個案的資訊。
評估要同時包括 sharpness 與 vacuity。這裡前者比較上界與整個期限內最大的響應絕對差,兩個峰值的高度差另行報告;峰值相同,不代表曲線相同。後者問界限是否大到無法認證名義警報。當經驗證的響應差範圍包含零,上界除以差值的比率就保留為未定義,並報告加性鬆弛量;不能隨意加一個分母下限,然後把修飾後的比例當成精確證據。
決策相關性也不同於絕對誤差。一個百分之一的界限,對離門檻很遠的峰值可能非常有用;對只差千分之一的峰值則完全無法判定。反過來,相對很鬆的上界,也可能足以證明舒適的 margin。因此,研究同時看響應尺度上的鬆緊,以及真正可認證多少決策。
還有已知兩個矩陣與整個不確定族的分別。比較 和一個已知 的證書,不會自動涵蓋鄰域內所有容許路由。要認證一整族,界限必須對整個集合一致有效;非負機率、每欄總和及指定擾動範圍都需要保留在集合定義之內。
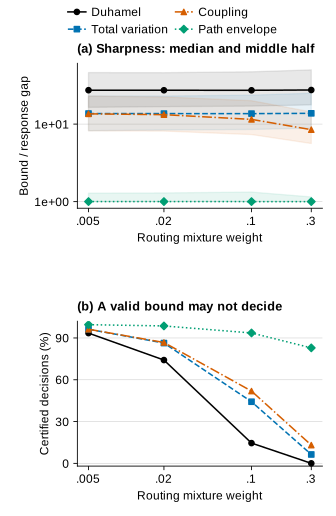
在 2,304 對路由中,上界/響應差比率的中位數依次為:Duhamel 27.38、total variation 13.69、coupling 11.47、path envelope 1.00045。正式集合沒有未定分母。但 path envelope 並非處處貼近:最大比率仍達 48.50。中位數大幅改善,不代表可以把它當成精確響應差。
保留路由資訊,可以怎樣改善界限?
物質守恆已經可以改善全域範數估計。兩個守恆轉移矩陣之差,每欄總和是零,因此正部與負部有相同總量。指定輸出分量對兩者的區分,不會超過機率響應的取值範圍。設共同擾動大小為 ,就得到 total-variation 容許量
Coupling 的解讀再保留一個事實:兩條已經分開的隨機軌跡,不需要被重複當成新分開的機率。先把兩個過程配對,直到路由第一次不同;最壞分離率為 ,得到
小擾動時,把指數展開,會回到半範數的一階結果。較大擾動時,coupling 容許量會飽和,不會隨範數無限增長。不過它仍然是最壞情況的輸入輸出上界,不是這一對網絡的精確差。每個隨時間變化的表達式,都要在相同監測期限內取最大值,才可用來包住峰值差。
對無環、相同等待率的模型,路徑機率可以再提供更具體的計算。令 ,用 表示長度不超過 的累積路徑機率之差。兩個完整分布總和都是一。把 Erlang 公式代入,再整理相同次方,可以得到
把有符號係數改取絕對值,就有路徑特定的包絡:
這保留哪些路徑長度機率改變,卻丟掉不同貢獻之間的抵消。如果累積差有正有負,丟失抵消可能令界限變鬆。如果兩個網絡的路徑長度分布完全相同,即使內部走線不同,這個包絡仍是零。終端這一個輸出,本來就不一定能辨認所有微觀路由改變。
這些改善不等於宣稱新方法。機率距離、Markov coupling、輸入輸出增益及路徑分解,都有成熟理論。這個基準問的是:在固定定義及預留測試之下,選定界限有甚麼表現?一個經過驗證的應用與負面結果,可以有研究價值,而不需要把所有推導包裝成新定理。
資訊成本也要公開。用到完整路徑分布的計算,知道的路由資訊多於特徵值篩選。如果它的前處理成本接近精確響應,價值可能是解釋或多次查詢重用,而不是加速。不能只展示最後一行公式有多快,卻把建立該公式所需資料的成本隱藏。
決策數目顯示這些差別有多大用途:
| 界限 | 全部 6,912 筆查詢中獲認證 | 6,740 筆不變查詢中獲認證 |
|---|---|---|
| Duhamel | 3,147(45.53%) | 46.69% |
| Total variation | 4,029(58.29%) | 59.78% |
| Coupling | 4,284(61.98%) | 63.56% |
| Path envelope | 6,473(93.65%) | 96.04% |
沒有任何證書與已驗證決策矛盾。Path envelope 仍對 439 筆查詢無法認證:全部 172 筆實際翻轉,以及 267 筆其實不變的個案。它認證相同,不認證不同;而且使用兩套路徑律,不只是兩組頻譜。
預留網絡測試,應該考驗甚麼?
一對直接與鏈式網絡足以說明,特徵值在原理上不足。它不能告訴我們這個限制在更廣路由族有多常見、界限通常有多保守,或程式離開最初例子後是否仍可靠。這些問題需要把開發與評估分開。
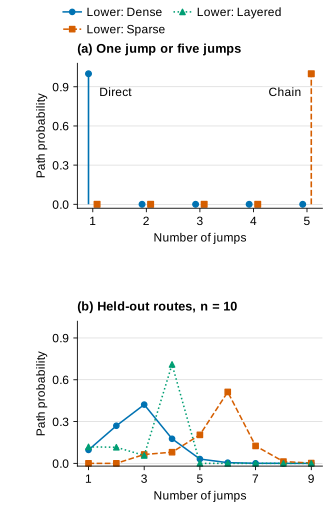
結構預留不是只在同一條熟悉曲線多取幾個時間點,而是換路由形態。開發個案可以暴露程式錯誤,並形成預先指定的比較規則;之後固定規則,才問不同短長路徑混合是否仍得到可信答案。如果先看完所有預留結果,再挑最戲劇化的圖,測試就退回示範集。
參數預留則考另一件事。改變 、、 或 ,會改變旅行、移除與監測之間的競爭。同一比較對仍然等頻譜、物理一致;不同參數區域的共同頻譜則可以不同。結構泛化與參數泛化應分開呈現,而不是用一個總百分比掩蓋兩者。
無量綱量能幫助整理區域。 描述期限內一般有機會完成多少轉移階段; 描述期限內有多少移除; 比較移除與轉移。只換時間單位時,速率與期限應一起縮放,不應產生新的物理結論。敏感度檢查若忽略這點,很容易把同一情境重複當成多個獨立發現。
門檻也屬於評估設計。高於所有峰值的門檻,會讓所有個案都沒有警報;低於幾乎所有峰值的門檻,則讓所有個案都有警報。兩者都容易得到漂亮的一致率,卻沒有證明篩選有辨識能力。因此,簡單與貼近門檻的情況都要保留,並交代門檻如何預先選定,而不是事後調整來幫某個方法勝出。
這些是構造網絡,不是實地隨機樣本。成功比例只描述指定基準分布,不能轉寫成水務設施、疫情傳播或供應鏈的危險盛行率。同一網絡用三個門檻評估,也不是三次獨立物理試驗;同一條曲線的很多時間點更不是。報告數字時,必須讓比較單位保持可見。
評估在九個結構族/尺寸區塊各使用八個獨立網絡:dense、sparse、skip-layered 路由,節點數為 6、10、20。跳躍率取 0.7、1.6,移除率取 0.075、0.15,期限取 2、4.5。每個基準與另一套路由作凸混合,,權重取 0.005、0.02、0.1、0.3;門檻取 0.15、0.35、0.55。三族的查詢改變數依次為 60、67、45,各自分母均為 2,304。這些是配對基準查詢,不是母體失敗率。
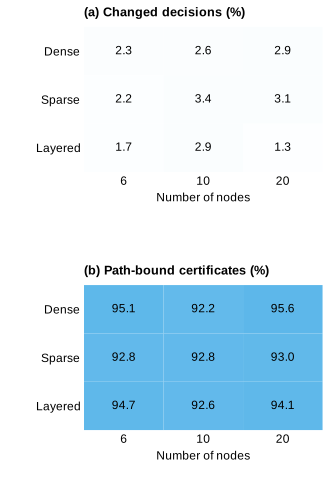
哪些失敗值得保留下來?
決策不變是有用的負面結果。有些路由變化幾乎不改終端響應;另一些會改峰值,但沒有跨過指定門檻。兩者都限制故事的普遍性:路由影響 transfer function,不代表每一對路由、每一個監測規則都必然翻轉警報。
空泛證書也是有內容的失敗。它指出界限保留的資訊,與感測器真正問的問題不匹配。如果離門檻很遠仍經常無法認證,可能是全域範數為不可達或無關改變付了太多代價;如果只在極小 margin 失效,困難可能來自決策本身,而不是界限設計很差。
數值未能判定也應留在結果中。提高精度或細化時間區間可能解決,但只能按預先指定的資源限制作。超出限制後,不應悄悄繼承名義峰值的正負號。否則最困難的個案,反而會得到最缺乏保障的確定標籤。
運算時間亦需要同樣紀律。路徑權重算好後,公式可能很快;矩陣指數則可能一次服務多個輸出。是否重用前處理會改變成本模型。合理報告分開前處理、響應求值、峰值驗證與證書建立,並區分操作次數與受硬件影響的實際秒數。
若一個方法給出較緊界限,卻需要更詳細路由與更多運算,便不能只用「較好」概括。它可能更適合需要保證的少量關鍵決策;簡單範數可能更適合大量快速初篩。研究應把資訊與成本放在同一張比較圖,讓讀者知道多得的結論是用甚麼換回來。
最有力的結論可以很克制:簡單頻譜篩選沒有能力區分某些決策;精確、路由感知的計算可以回答;嚴格 margin 只在部分區域成功。失敗若能指出每種方法丟掉哪一層資訊,便比宣布某個方法處處勝出更有用。
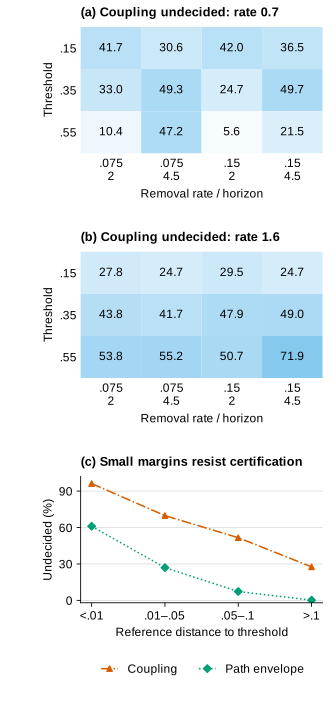
便宜的篩選,可能剛好刪掉決策最需要的資訊。因此,成本不應只與算出一個數字的秒數比較,還要與未能判定或錯誤標籤的後果一起理解。如果同一名義路由會被很多門檻重複查詢,預先計算的響應包圍可以重用;如果每次查詢都改圖,這種重用可能不存在。先定義工作量,才有資格談加速。
數值參照與可部署規則也不是同一角色。驗證階段可以刻意用兩套獨立表示重複核對,這不代表未來每次警報都必須支付兩套計算;但報告產生已驗證基準的成本時,又不能把核對工作全部省略。分清「建立可信結果」與「重複使用結果」,才能知道比較到底在計甚麼。
時間資料還有另一個限制。同一程式在不同電腦、不同線性代數程式庫、不同核心數上,實際秒數可能改變;操作次數則可以較直接反映算法做了多少事,卻仍不等於各種操作成本相同。一次矩陣指數與一次標量多項式求值,不能只因都叫一次就當作相等。本文把兩者並列,而不把其中一欄包裝成唯一效率答案。
若嚴格峰值驗證耗盡細化上限,這筆工作仍然已經發生。把失敗個案從平均時間刪掉,會讓方法看來較快,也會讓成功率看來較高。公平的比較保留完整嘗試,並說明哪些成本只服務特定保證。這不保證圖表會漂亮,但能避免把計算上最困難的一部分變成看不見的帳。
其中一次完整運算,每條曲線的峰值驗證時間中位數為 36.24 ms,三門檻跨越檢查為 89.45 ms,矩陣指數參照為 7.06 ms。這些組件給出不同保證,也未包含所有前處理,因此相除不等於端到端加速。另設的近邊界控制也提醒我們:典型時間不能取代細分預算及保留未定結果的政策。
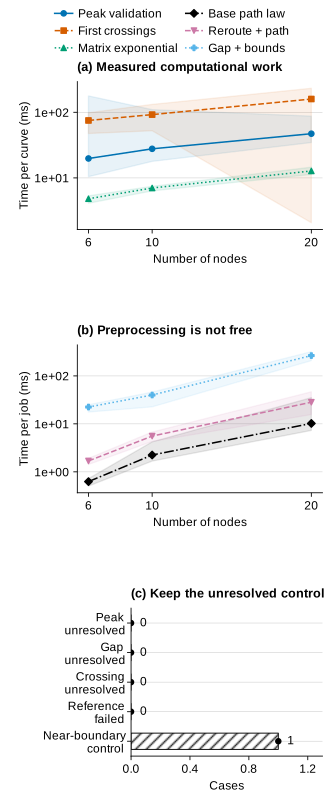
模型刻意沒有回答甚麼?
區室狀態是物質量。要把它解讀成濃度,需要相同區室體積或明確體積正規化;要解讀成劑量,需要暴露模型;要解讀成工程安全,需要校準參數、量測不確定性與適當標準。單位釋放的數學圖,不會自動完成這些轉換。
統一移除也是刻意限制。它讓總存活量與路由無關,並提供乾淨的傳播範數。如果各區室移除率不同,換路由會同時改變旅行與接觸移除的位置。那可能值得研究,但需要另一套公平比較與修改後的證明,不能把平均移除率直接塞進現在的證書。
真實網絡可能有循環、隨時間變化的流量、依庫存而變的轉移、非線性反應、未知路由或感測位置誤差。這些都可能改變到達分布與固定生成矩陣的意義。現在的模型建立一個受控的資訊缺口,不是聲稱已驗證所有這類系統的近似。
我們也沒有試圖把 nonnormality 當成唯一解釋。全域放大範數問的是最壞狀態方向;指定釋放後的一個感測器問的是輸入輸出。正值收支限制可以禁止總一範數增長,同時容許某個區室明顯增加。不同範數與不同觀測量,不應被當成同一種物理風險互相比較。
這個焦點補充了先前的衰減證書研究:證明最終衰減,與檢查有限時間門檻,是不同工作。它亦補充正值數值建模:可信暫態首先要遵守非負性與物質收支,之後才有資格解讀警報。這裡再問,當基本物理條件都做對之後,哪些資訊仍然被頻譜摘要藏起來?
結論
兩個網絡可以有完全相同的特徵值,損失完全相同的總物質,卻在有限時間內給出不同感測讀數。缺失的資訊不是一種新不穩定性,而是從指定釋放至指定觀測的路由相關轉移。經典 phase-type 計算把這個機制寫清楚,也為矩陣指數提供獨立核對。
因此,最強的實證結論仍有條件:路徑資訊令更多決策可以得到認證,但沒有消除棄權,也沒有令每次路由變化都變得重要。
嚴格決策 margin 可以比畫曲線多做一步:在明確模型假設之下,排除門檻翻轉。但有效不等式仍要接受用途測試。如果幾乎所有個案都只能回答不知道,就未算解決監測問題。預留結構、參數變化、界限鬆緊、空泛比例與保留失敗,決定結果能走出教學反例多遠。
因此,遇到一組令人安心的特徵值時,值得先追問:對哪一次釋放、哪一個感測器、哪個門檻,以及多長期限而言安心?當問題定義清楚,穩定性分析、精確暫態計算與穩健性證書,就成為互補工具,而不是彼此取代的口號。
研究問題與有限度解讀見專案概覽。
參考文獻
- Bao、Dai、Nagler 與 Lin。Quantifying Transient Dynamics in Heterogeneous Networks under Various Inputs(2025)。有向遊走與輸入相關暫態是密切先行研究,不是本文提出的新機制。原始預印本。
- Hurtado 與 Richards。Building mean field ODE models using the generalized linear chain trick and Markov chain theory(2021)。正式論文。
- Metzler 與 Sierra。Linear Autonomous Compartmental Models as Continuous-Time Markov Chains: Transit-Time and Age Distributions(2018;2017 年先於網上刊出)。正式論文。
- Trefethen 與 Embree。Spectra and Pseudospectra: The Behavior of Nonnormal Matrices and Operators(2005)。出版社。
- Nazerian、Asllani、Tyloo、Ku 與 Sorrentino。The frequency response of networks as open systems(2026)。輸入輸出及頻率響應分析是密切先行研究;本文的有限期限物質量門檻是另一個績效問題,不是首次引入網絡轉移。正式論文。
- Rantzer。Distributed Control of Positive Systems(2012 年預印本,2014 年修訂)。正值系統的輸入輸出分析。原始預印本。
- Mitrophanov。Ergodicity coefficient and perturbation bounds for continuous-time Markov chains(2005)。正式論文。
- Mitrophanov。The Arsenal of Perturbation Bounds for Finite Continuous-Time Markov Chains: A Perspective(2024)。正式綜述。
- Asllani、Lambiotte 與 Carletti。Structure and dynamical behavior of non-normal networks(2018)。正式論文。