一條沒有紅綠燈、沒有匝道的環形道路,也可以出現忽快忽慢的車流。前面的車稍為減速,後面的車調整速度,再把擾動傳給下一位駕駛員。有時這段波動逐漸消失,有時卻會愈傳愈強。問題不只在於每輛車現在開多快,還在於車距與速度如何一起決定下一刻。
假設我們不想追蹤所有車輛,只想保留一條描述主要交通波的曲線。一個模型只看當前曲線,另一個模型再看過去幾秒。若後者預測較準,可以說它找回了被粗粒化丟掉的記憶嗎?這個解釋很自然,但仍然有幾種可能:當前觀測真的不足;過去資料只是幫助估計雜訊中的真值;或較大的回歸模型剛好比較適合指定的資料。
本文用一個能夠逐步拆開的合成交通系統比較這些解釋。我們知道每輛車的方程,也能計算完整線性系統的精確演化,再刻意只讓縮小後的模型看見部分資訊。這樣可以把「預測改善了」與「為甚麼改善」分開檢驗。項目簡介提供較短的研究摘要;以下會從狀態選擇、記憶核、穩定邊界與失敗案例,說明比較的含義。
最先出現的結果是一個否定例。在相同駕駛員、微小擾動的條件下,只要同時保留第一個車距與速度 Fourier 模態,這四個實數已經形成閉合的線性系統。被刪去的其他模態不會回頭影響它。此時加入歷史,並沒有一個真正缺失的線性記憶核需要修補。
隨後的兩個改動才帶來不同機制。若只看車距、藏起速度,現在的車距便不能單獨決定未來;若讓駕駛員的反應率各不相同,不同空間模態開始耦合,即使保留車距與速度的第一模態,仍然會受到其餘模態影響。再加入觀測雜訊,歷史還會多出濾波與估計的作用。三者都可能令長一點的輸入序列有用,但不能用同一句話概括。
這是一項既有理論與方法的受控擴展研究。Mori–Zwanzig 投影、最佳速度交通模型、延遲回歸與含雜訊的動態辨識都有長期文獻,交通預測也已有明確使用 Mori–Zwanzig 思路的工作。本文的價值在於把幾種容易混淆的解釋放在同一套可核對的比較中,而不是宣稱提出新的記憶理論。
先看見結果,再問它支持甚麼
主比較包含 33 組道路與駕駛員配置,每組沿反應率取九個位置,共 297 個設定。每個設定各有 12 條訓練、6 條驗證及 12 條測試軌跡,合共 8,910 條完整線性軌跡。加入不同觀測雜訊後,完成 23,463 個模型設定的擬合與評估。這些是固定設計與指定隨機初值下的合成比較,不是 23,463 次獨立的真實道路觀測。
比較顯示,歷史在異質駕駛員與含雜訊條件下可以改善預測。但是,同質且有雜訊的控制組也出現改善,而那裏的精確線性記憶核為零。另一方面,十六階模型雖然只觀測四個變數,實際滾動預測要保存 64 個狀態值,已經多於完整線性交通系統的 47 個自由度。預測品質、機制解釋與壓縮程度,需要分開評分。
一條可以仔細檢查的環形道路
道路上有 輛車,車輛編號按行駛方向固定。第 輛車與前車之間的間距是 ,速度是 。最後一輛車的前車接回第一輛,因此沒有道路入口、出口或外部車流。微觀模型採用最佳速度形式:
第一條方程是幾何關係。前車比自己快,車距增加;自己比前車快,車距縮小。第二條方程描述速度向指定車距所容許的最佳速度調整, 是反應率,單位為每秒。較大的反應率代表較快的鬆弛調整,而不是在方程中另加一段明確的反應延遲。
間距以公尺計,速度以公尺每秒計。曲線在零間距時給出零最佳速度,間距增加時平滑上升,並逐漸接近每秒 30 公尺。這是一個方便分析的指定函數;本研究沒有以實際駕駛資料估計其中的數值,也沒有證明它能代表某個城市的交通。
均勻車流具有相同間距 和相同速度 。即使駕駛員的反應率不同,這仍然是平衡狀態,因為每位駕駛員已經達到相同的目標速度。差異會在擾動出現後顯現:有人較快調整,有人較慢,原先簡單的空間波便可能與其他波形交換資訊。
我們比較平均間距 12.5、15、17.5 公尺,對應環長 300、360、420 公尺。這裏的車輛是點狀模型,沒有另扣除車身長度,所以「間距」與實際保險桿之間的淨空需要區分。這些設定用來控制密度及速度曲線斜率,不是建議道路應保持的安全距離。
加總第一條方程,所有速度項恰好抵銷,得到 。這個守恆量既是數學性質,也是程式需要核對的條件。但守恆不等於物理上永遠有效:某個間距可能降到零,其他間距同時增加,總和仍然正確。因此模擬同時檢查最小間距,首次碰撞事件出現便停止,不讓無效軌跡繼續進入評分。
用週期位置差的取模來計算間距時,需要特別小心。如果車輛越過前車,負的距離可以被取模成一個很大的正值,表面上好像重新得到合法車距。本文直接積分固定車序的間距與速度,並記錄事件,避免幾何表示掩蓋模型已經失效的時刻。
用四個數字保留一個交通波
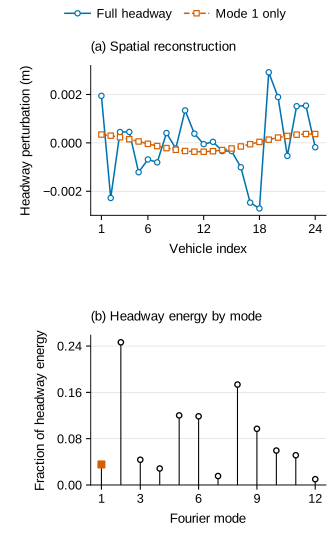
逐車資料包含很多空間細節。我們把各車與均勻狀態的差值分解成 Fourier 模態:第一模態沿整條環路起伏一次,第二模態起伏兩次,依此類推。這不是把道路畫成直線後任意截斷,而是利用環形空間的週期結構。
第一個車距與速度模態定義為
每個複數各有實部和虛部。兩者共同表達波的振幅與相位:振幅告訴我們起伏多大,相位告訴我們波在環路哪個位置。若只留下絕對值,兩個在不同位置的交通波可能變成同一觀測,也會把方向與傳播資訊丟掉。本文保留實部和虛部,縮小後的基本觀測因此是四維。
這四個數字不是全體車速平均。對每個非零 Fourier 模態而言,均勻的加速或減速會相互抵銷,而空間上有組織的波動會留下訊號。因此,模型學習的是指定交通波如何演化,而不是所有乘客或所有路段的平均體驗。
比較車距與速度時,也不能直接把公尺平方和公尺每秒的平方相加。我們先用固定的 12 公尺與每秒 30 公尺作尺度,再使用實數正交 Fourier 座標。這使所有座標無因次,並令不同通道的相對權重有明確來源。回歸時另用訓練資料估計通道尺度;那是數值調節,與物理無因次化的角色不同。
完整的間距與速度有 48 個座標。因為道路長度固定,平均間距不能任意改變,我們把這一個守恆方向移除,保留 47 個自由度。平均速度仍然保留在完整系統中;它一般可以變化,不能因為我們主要關心第一模態就把它誤當成另一個守恆量。
其中 把速度轉為前車與本車的速度差, 的對角元素是各車反應率, 是移除平均間距的實正交 Fourier 變換。其首四個座標等於 。這個常數正規化把常用複數模態與數值運算座標連接起來,不改變是否閉合的結論。
選擇第一模態有清楚的解釋,也有明確限制。若某個不穩定方向主要集中在更高模態,它在四維觀測中的投影可能很小。完整系統已經有增長,第一模態卻幾乎看不見,這是觀測能力的問題。多看幾秒的歷史有時能補足線索,但不能保證任何隱藏的不穩定方向都會在指定輸出中留下足夠訊號。
同時看見車距與速度,記憶可以完全消失
先令所有駕駛員有相同反應率 ,再只研究均勻狀態附近的微小擾動。此時以最佳速度曲線的斜率 線性化。不同 Fourier 模態互不耦合,所以我們可以單獨寫出第一模態的方程。
令 、,便有
這裏的 分別是第一車距與速度模態。兩條複數方程相當於四條實數一階方程。右邊只出現已保留的 ,沒有其他模態。因此,只要當前四個數字已知,線性模型便能決定它們的未來;過去的資訊並不是狀態完整性所必需。
這個結論不是由回歸分數猜出來,而是直接來自方程。即使刪去大部分車輛尺度的座標,仍可能恰好留下了一個不受其餘座標影響的子系統。「少了很多變數」不自動等於「必須有記憶」;關鍵在於被刪去的方向會否回饋保留的方向。
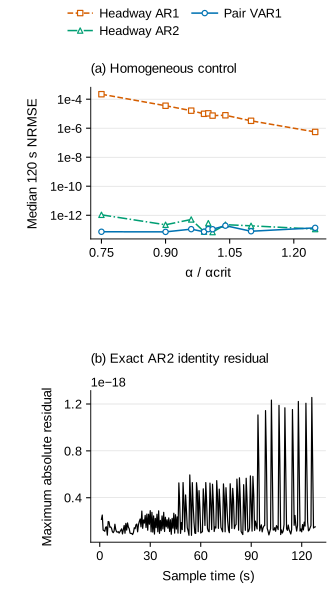
對這個閉合系統精確取樣,每隔 秒的狀態都由同一個矩陣乘上當前狀態得到。沒有離散化近似、沒有觀測雜訊而且資料足夠時,一階線性回歸應該能學到這個映射。它是整項比較的重要負對照:若在這裏宣稱深長的歷史是恢復物理記憶的必要條件,便與已知結構矛盾。
實際控制結果與此一致:沒有觀測雜訊時,四維一階模型的 120 秒正規化誤差中位數約為 ,接近數值精度。更長歷史在最後幾位數字的差別,不能當成具有物理意義的效益。
微小擾動的增長率由上式的特徵值 決定,臨界反應率為 。
當反應率跨過 ,主導模態由增長轉為衰減。在這個同質環路中,第一非零模態給出最大的臨界反應率,因此可以用來判定均勻流的線性穩定性。有限車數的餘弦因子需要保留;直接使用無限大系統的近似 ,會混入一個其實可以避免的邊界偏差。
例如平均間距 15 公尺時, 約為每秒 0.678507,臨界反應率約為每秒 1.333895。反應率為每秒 1.6 時,第一模態的慢特徵值實部約為每秒 ,代表緩慢衰減。負號很小,不等於數值上不重要:若模型把它估成小正數,短時間仍可畫得很像,長時間卻會朝相反方向走。
這裏的邊界是均勻流對無限小擾動的線性失穩邊界。有限振幅可能產生更複雜的波、非線性飽和或其他吸引子,並不由一條線性判準全部決定。本文使用「穩定邊界」時,主要指這個有明確參考值的局部問題,不把它擴大成所有交通堵塞的完整相圖。
藏起速度之後,當前車距便不再足夠
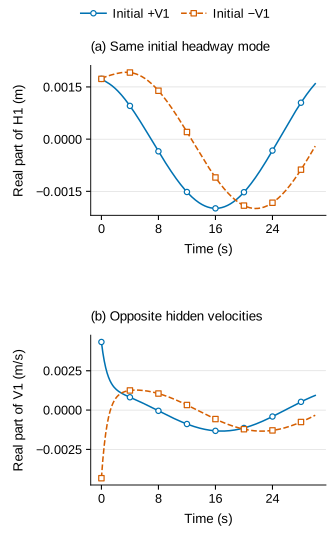
現在保留相同的同質微觀模型,只改變觀測:我們仍看見第一個車距波,卻不再看見速度波。兩個系統可以具有完全相同的 ,但一個的前車相對較快,另一個相對較慢。由 可知,它們的車距波下一刻便會不同。
這是一個直接的辨識限制。任何只接收當前 的確定性模型,面對相同輸入只能給出相同預測;但完整系統容許不同未來,所以該模型不可能對所有隱藏速度都正確。增加過去的車距觀測,可以提供變化方向與速度的線索,正好對應到剛才藏起來的資訊。
把速度方程解出,再代回車距方程,得到
第二項把過去的車距波加權累積起來,權重隨時間差以指數衰減。這是由消去速度直接得到的精確記憶表示。第一項則保存最初隱藏速度的影響;如果把它刪掉,兩條起點車距相同、速度不同的軌跡仍會被錯當成一樣。
把第一項叫作「雜訊」時也要留意語境。在這個例子中,完整初值與方程都是確定的,所以它並不是另外加入的隨機擾動。只有當我們把未知初值視為來自某個機率分布,才可以再討論相應的隨機描述。未知、隨機及獨立白雜訊是不同概念,不能互相替換。
連續記憶積分看起來需要保存整段過去,但同一系統的離散觀測其實有精確二階遞推。設 是完整兩維複數系統經過一個取樣間隔的轉移矩陣,Cayley–Hamilton 恆等式給出
因此,一條有無限指數尾巴的連續記憶核,可以由有限個輔助狀態或短遞推精確表示。這不代表任意記憶都能如此壓縮,而是提醒我們:保存多久的原始歷史、使用多少階遞推,以及系統真正有多少隱藏自由度,不是同一個問題。
這個正對照也不能只取一段晚期曲線來測試。若快速模態早已衰減,資料幾乎只剩一個慢模態,車距單獨看起來也可以接近一階。主實驗中,無雜訊的車距一階模型在指定晚期預測窗口已有很小誤差,並沒有因此推翻完整的二階結構。我們另用同車距、異速度的成對初值,直接顯示最初分歧,避免把資料中的簡化誤當成所有初值都成立的定理。
不同反應率,令空間模態重新聯繫
接着讓駕駛員反應率不同,但維持同一條最佳速度曲線。這個選擇刻意只改變調整速度的時間尺度,不同時改變目標速度、車輛長度或希望保持的距離。否則均勻平衡本身也會改變,便較難辨認記憶是在哪一步出現。
反應率指定為 ,其中 ,而 。
24 位駕駛員中,一半較快,一半較慢,再把他們在環路上的位置隨機排列。平均反應率恰好是 ,相對標準差是 。我們使用 ;每個非零強度有五種固定排列。掃描平均反應率時,排列本身不變,避免把兩種改動混在一起。
同質系統的空間平移對稱性令 Fourier 模態各自演化。駕駛員反應率隨位置改變後,這種簡單的分離不再成立。一個第一模態擾動可以激發其他模態,其他模態又能回饋第一模態。因此,先前閉合的車距與速度配對,現在通常只是更大系統的一部分。
這裏的「隱藏變數」並不是某個神秘的駕駛習慣。我們在完整模型中清楚知道它們:第二、第三及其餘 Fourier 模態,以及可能參與耦合的平均速度。研究者知道完整狀態,縮小模型只看見其中四個座標,便能明確計算被刪去部分如何回來影響輸出。
把完整的無因次線性狀態分成保留部分 與隱藏部分 ,方程寫成 及 。
這四個區塊分別表示可見部分自身演化、隱藏對可見的影響、可見對隱藏的激發,以及隱藏部分自身演化。矩陣由已知的交通方程與座標變換構成,不是先做回歸才得到。因此我們可以用它建立一個不受模型選擇分數影響的機制參考。
用常數變易公式消去 ,便得到
這條式子把三種影響分清楚。瞬時項只看當前 ;記憶項先由可見狀態激發隱藏狀態,再經隱藏動力學演化,最後回到可見狀態;最後一項則來自一開始已存在的隱藏資訊。記憶核因而描述一條回饋途徑,而不只是「舊資料的權重」這個直覺。
這是指定線性座標投影下的精確消元恆等式。Mori–Zwanzig 理論提供更廣泛的投影框架,但不同投影、內積、初值分布及觀測函數會產生不同算子。本文沒有把這個確定性線性推導,冒充成任意非線性交通資料下都成立的同一個核。
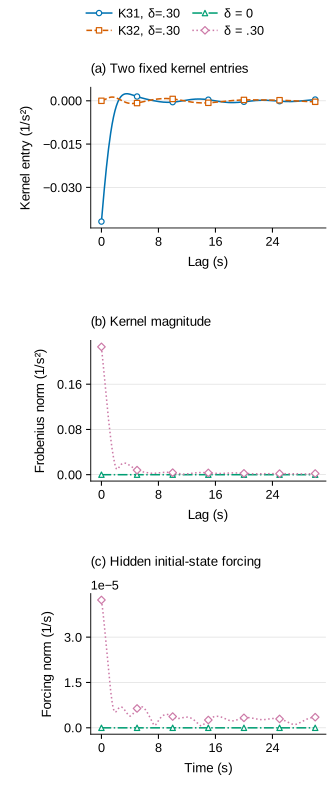
同質情況的核最大值約為 ,實際上是座標計算的浮點殘留;其積分殘差也停在數值底限,不能再從幾乎不變的小數擬合收斂階。異質代表案例的核最大元素約為 0.154,則明確超出這個底限。兩者的比較支持「耦合開啟了記憶途徑」,而不是只從一條看似較好的預測曲線倒推原因。
還有一點容易被忽略:這個異質案例的隱藏區塊 具有正的最大特徵值實部,約為每秒 0.00362。因此,不能預設核的所有部分都會快速衰減,也不能因為看見指數矩陣就認定幾秒後可以安全截斷。決定某段歷史是否足夠,需要實際檢查耦合、時間尺度與預測目標。
同一批駕駛員換位置,真實邊界竟然不變
不同排列會改變 Fourier 座標中的耦合,因而改變記憶核。但是,在本文這個特定線性化 OVM 中,完整系統的特徵值只取決於反應率有哪些值,不取決於它們按甚麼次序排在環路上。這個結果可以直接推導,並不需要依靠五種排列恰好算出相近數字。
對特徵值 而言,速度方程先給出車距與速度之間的關係,再代入間距方程,得到
沿着環路走一圈,最後必須回到原來的速度分量。因此,完整系統的特徵多項式為
式中只出現乘積,交換任何兩位駕駛員都不改變它。這個推導只除以正的 ,沒有除以 ,所以不會在零特徵值附近偷偷丟掉一個解。固定總間距之前, 是一個簡單根;移除平均間距方向後,47 維系統的特徵多項式就是 的多項式延拓。
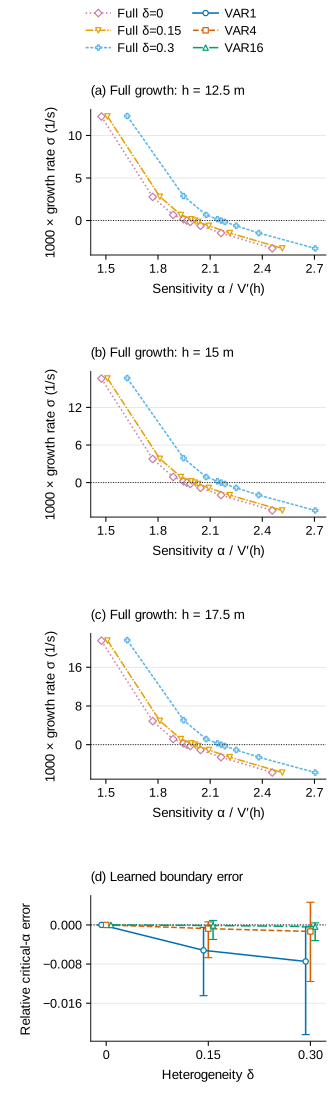
這提供了一個很好的比較設計:完整系統的增長率和真實邊界相同,但縮小模型所見的耦合方式不同。若某個排列較難預測,便不能一律解釋為那組駕駛員的真實失穩門檻改變,也可能是同一個完整系統頻譜,以不同方式投影到可見變數。
因此,圖表中跨駕駛員排列的分散程度,描述的是投影、辨識與預測的變化。它不是五條彼此不同的真實穩定邊界所產生的不確定度。即使在視覺上畫成範圍或誤差棒,也要清楚說明被彙總的量,否則讀者很容易以為駕駛員排列讓真實臨界值隨機漂移。
邊界附近,錯一個符號就有不同的未來
軌跡均方誤差回答「預測值與真值差多少」。穩定性則回答「小擾動最後會衰減還是放大」。兩者相關,但並不互相保證。若真實增長率非常接近零,短時間內正負兩種指數曲線仍可相似;若只看一個固定窗口的平均誤差,便可能漏掉這個方向性錯誤。
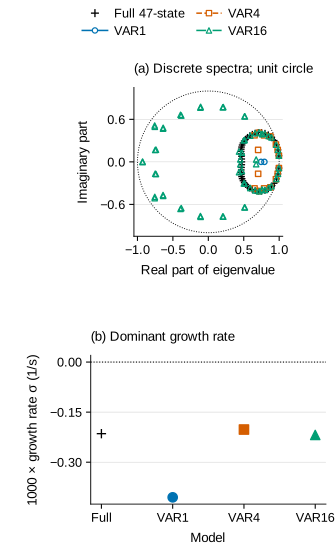
完整系統使用所有 47 維特徵值中的最大實部作增長參考。對離散回歸模型,我們組成包含所有延遲狀態的 companion matrix,以其最大特徵值模數換算連續時間增長率:
這個量反映已擬合線性遞推允許的最強增長方向,未必等於有限測試軌跡在短窗內量到的斜率。有些方向可能只被初值微弱激發,有些模型則出現與主要資料方向無關的額外根。因此我們同時保存模型頻譜與相同時間窗內的軌跡增長,不用其中一個量替代另一個。
判斷符號時,在每秒 以內視為臨界。這個明確指定的帶寬避免把數值零附近的微小正負誤差當成確定的失穩事件。每組配置也包括解析或數值求出的臨界點,這些點保留為 marginal 類別,沒有塞進穩定與不穩定的二元分母。
本文的「穩定性分類不一致」包含兩種情況:模型預測與真值相反的增長符號,或真值非臨界而模型落入臨界帶。它不僅計算正負顛倒。例如無雜訊異質 VAR4 的兩次不一致,一次是相反符號,另一次是預測臨界。
對異質完整系統,我們在相對斜率的固定範圍內掃描 201 個對數間隔反應率,再對所有觀察到的符號交點求根。這是有界的數值搜尋,不是證明區間外沒有其他邊界,也不保證找到所有相切而不變號的根。本次 33 組配置各找到一個參考交點,於其兩側使用相同的九個比例位置。
縮小模型在九個位置各自重新擬合,然後從它們的增長估計作線性內插,得到估計交點。這些交點是指定參數網格上的估計,精度受網格與擬合共同限制;不能把它們和完整矩陣的高精度求根結果都稱為同樣精確的解析臨界值。
讓資料、選擇與比較各守自己的位置
每個設定都有獨立初值的訓練、驗證與測試軌跡。初值包含完整 Fourier 座標中的多個方向,避免只激發一個本來容易擬合的波。所有方向先按固定的物理無因次均方根尺度縮放為 ,每條軌跡取樣到 128 秒,間隔為 0.5 秒。
預測從第八秒開始。所有方法都可以看見從零秒到第八秒的因果觀測,但各自使用所需的最近歷史;之後不再把真正的未來值餵回模型。評估窗口是預測起點後 10、30、120 秒。這種自由滾動比逐步讀入真值的單步評分更容易顯露小誤差如何累積。
基礎比較使用四維 VAR 的一、二、四、八、十六階。它們把當前和過去的觀測一起線性映射到下一次取樣,不加自由常數項,因為擾動零點應該仍對應均勻平衡。所有階數共用相同的訓練目標時間列,不讓長歷史因可用列數不同而獲得另外一組資料。
我們也加入八維的一階模型,同時看第一和第二 Fourier 模態。它只需要當前狀態,卻取得更多空間資訊;計算預測誤差時,仍只評分與四維模型相同的首四個座標。這個對照回答另一個實際問題:如果可以改善感測或保留更多觀測,是否比儲存更長歷史有效?它不是相同資訊條件下的完全公平排名,因此圖文會明確標示額外觀測的優勢。
回歸的正則化強度由獨立驗證軌跡選擇,目標是 10 秒與 30 秒的平均誤差。這是一個合成研究,可以取得乾淨驗證狀態;真實部署若沒有潛在真值,就不能直接照抄這種選擇條件。測試軌跡與測試增長符號沒有參與調參,模型也沒有被事後改造成必然穩定。
其中 是延遲輸入、 是下一時刻的目標, 是訓練列數, 是正則化係數。除以列數後,不同可用資料量下的懲罰尺度有一致解釋。這裏的 與觀測雜訊強度是不同量,不能由符號看起來相近就混為一談。
每個道路參數和駕駛員排列,都有自己的訓練資料與模型。因此,結果描述的是局部系統辨識:在某組條件下學得的模型,能否處理新的初值。它不代表同一模型未經重新辨識就能遷移到另一密度,也不代表只在穩定一側訓練後成功預測未見過的不穩定一側。
這個區分看似保守,卻讓比較有清楚含義。如果把每個參數點都重新擬合的結果畫在同一張相圖上,讀者很容易以為是一個模型跨越整片參數空間。實際上,圖中的每個位置都有新的辨識工作。要研究參數泛化,下一步必須定義共享模型如何接收參數,以及哪些參數在訓練時完全不可見。
預測更準,與邊界更準,並非同一排名
在異質、沒有觀測雜訊的組別中,四維一階模型的 120 秒正規化誤差中位數約為 0.0404,二階為 0.0284,八階為 0.0156,十六階為 0.0166。歷史確實帶來改善,但誤差沒有隨階數一直下降;最長歷史不是每個指標的最佳選擇。
邊界判斷也呈現類似細節。一階模型在 240 個非臨界設定中錯 12 次,二階、八階與十六階均為零次,四階則錯兩次。這不是說四階在數學上必然較差,而是目前回歸目標、資料與正則化選擇下的結果。模型驗證以短期誤差為目標,沒有直接優化增長符號,因此兩種排名本來就可能不同。
增加觀測的八維一階模型,在同組別的誤差中位數約為 0.0269,穩定性分類不一致三次。它比基本四維一階模型更了解當前空間結構,卻仍沒有完整觀測 47 維狀態。保留更多模態與保留更多時間,各自補足不同資訊;這個比較沒有提供一條對所有感測條件都最便宜的方案。
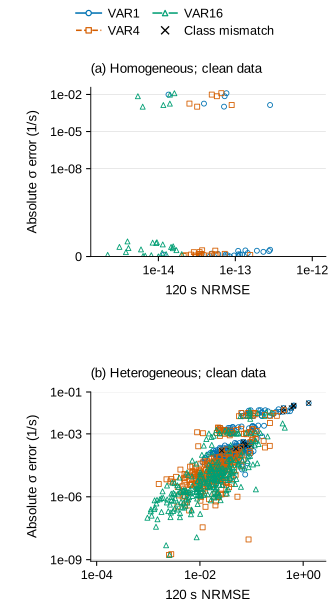
正規化誤差的分母也需要說清楚。每個通道使用乾淨訓練軌跡的均方根尺度,所以 0.04 表示誤差相對於這個訓練訊號尺度,而不是車速錯了 4%,也不是所有車距的平均相對誤差。在訊號接近零的時刻,這種固定分母比逐點相對誤差穩定,但它依然是一個明確選擇的度量。
主導完整模態的可見性則限制了符號比較的解釋。有些設定中,最快增長方向在第一模態的投影極小;有些設定中,投影幾乎包含整個主導方向。我們保存這個量,是為了讓全系統失穩與指定觀測的可辨識程度分開,而不是把所有分歧都算成少記了幾秒。
雜訊也會令歷史變得有用
觀測雜訊加在已經生成的乾淨軌跡上,標準差分別為各通道乾淨訓練均方根尺度的 1% 與 5%。每個非零強度有五個獨立實現,同一份受污染觀測同時提供給所有模型。訓練與預測前的歷史都帶雜訊,最後則對已保存的乾淨狀態評分。
這樣可以確保模型不是只在訓練時面對困難,卻在預測起點偷偷得到完美狀態。也不能為不同方法各抽一份剛好比較容易的噪聲。若用歷史做平均或估計,必須只使用預測開始前的資訊,不得從未來真值反向平滑。
同質負對照最能拆開解釋。它的車距速度配對本來已經閉合,精確物理記憶核為零。但在 5% 雜訊下,一階模型的 120 秒誤差中位數約為 0.144,十六階降至 0.0108;穩定性分類不一致由 120 個非臨界實現中的 40 次,降至零次。這一大段改善不可能證明找回了原本就不存在的線性耦合核。
在異質組別中,5% 雜訊下的一階誤差中位數約為 0.157,十六階為 0.0311;1,200 個非臨界實現中的分類不一致分別為 406 次與 6 次。那裏同時存在被隱藏的動力學與觀測誤差,長歷史可能兼有重建與濾波作用。僅從兩個分數的差,無法分配其中多少來自哪一種機制;控制組比一句籠統的「記憶有效」提供更多解釋。
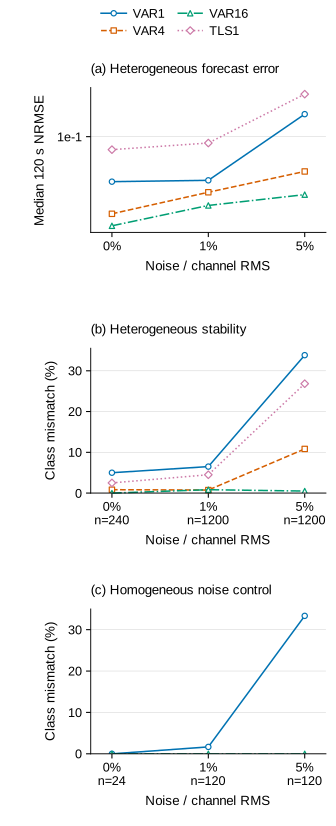
總最小平方法對照同時考慮輸入與輸出快照的誤差,用來檢查單側回歸偏差。然而,它不是萬用的雜訊修正。資料矩陣的條件、訊號的快慢尺度、可辨識子空間,以及雜訊假設都影響它的行為。主比較共有 88 個非有限結果,全部出現在 TLS:異質組 5% 雜訊有 53 個,同質組 1% 與 5% 雜訊分別有 17 與 18 個。有限結果的中位數排除了這些非有限值,必須與失敗數目一起報告;本次還出現極大的有限誤差,不能只選成功案例便宣稱消除了雜訊影響。
時間歷史還會改變觀測誤差的結構。相鄰訓練列重複使用某些快照,一次觀測噪聲可以同時出現在多個延遲位置。因此,殘差小或看起來不相關,並不自動代表獨立白雜訊。把回歸係數稱為物理記憶核,還需要投影定義、殘差構造與相應一致性條件;普通聯合延遲回歸沒有自動滿足這些要求。
非線性壓力測試,也要先分清數值誤差
主比較的真值來自完整線性矩陣指數。為了看看結論離開微小擾動後是否仍站得住,我們另外以非線性最佳速度方程生成軌跡。這裏只使用事先選定的代表配置與測試方向,把初始無因次均方根振幅放大至 0.01 和 0.05,並保留 的小振幅對照。
這些測試使用已從線性資料選出的模型,沒有針對非線性結果重新調參。它們回答的是既有局部縮小模型能承受多大改變,而不是最好的非線性模型能做到甚麼。總共嘗試 288 條軌跡,其中兩條在大振幅初值下出現負速度而不符合物理輸入條件;這兩條保留為失敗,沒有重新抽方向。
其餘 286 條有效軌跡沒有觸發碰撞。這只描述指定方向、振幅與觀察時間,不能當成這個 OVM 對任意初值都安全的證明。最小間距、最小速度及總間距誤差也都保留,讓「沒有碰撞」不至於只是一句沒有檢查依據的結論。
最值得注意的現象,出現在很小振幅。某個異質案例的十六階模型,使用原先非線性求解容差時,120 秒誤差約為 1.837;把相對與絕對容差收緊後,誤差變成約 0.0159,再收緊一次則為 0.0181。這種大幅改變說明,原本那個小振幅失敗不能直接解釋成物理非線性。
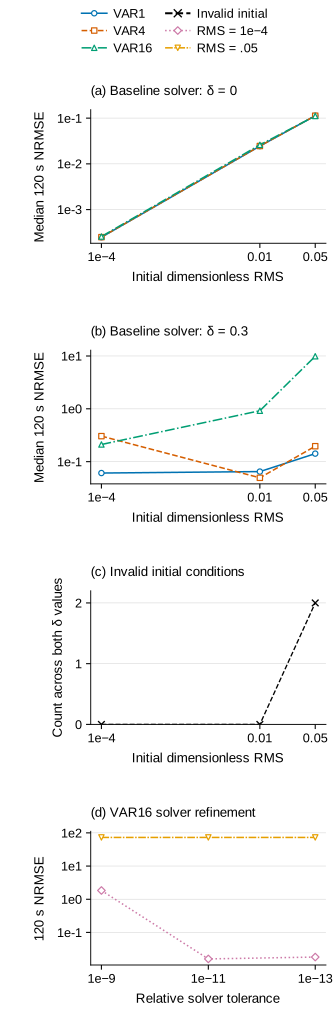
為甚麼很小的軌跡差異可以導致那麼大的預測差異?長歷史模型可能使用彼此很大的正負係數,在接近理想資料子空間時精細抵銷。微小的數值擾動一旦離開那個子空間,便可能被放大。主導特徵值沒有明顯不穩定,也不代表所有有限時間的擾動都溫和;矩陣的條件與非正規性同樣影響敏感度。
較大振幅的同一案例則不同。十六階模型的誤差在三組求解容差下約為 72.8425、72.8447、72.8448,沒有隨細化消失。這支持「此線性歷史模型在指定有限振幅下失效」的判斷,卻仍不是所有記憶模型或所有交通場景的普遍失敗定理。
我們因此保留原先壓力測試,再把細化結果標為針對異常的追加診斷。若直接換成較漂亮的新數字,讀者便看不見原先流程對微小數值誤差有多敏感;若拒絕檢查而把所有壞分數都算作非線性效應,又會給出錯誤解釋。可靠的結論需要同時保留兩層證據。
記住更多,未必代表模型更小
VAR 的階數計算的是取樣數,不是物理時間。在每隔 0.5 秒取樣的主比較中,十六個歷史值從當前追溯至 7.5 秒前。把它叫作「八秒記憶」會混淆資料窗口與相對於下一次預測的最遠延遲。因此我們分別記錄階數、歷史跨度及共同的預測起點。
若取樣改成每隔 0.25 秒,維持八秒跨度便需要更多歷史值;若取樣改成每隔一秒,同樣跨度只需要較少值。補充比較固定 0、2、4、8 秒的物理歷史,再改變取樣間隔,避免把「資料較密」誤說成「系統需要記得更久」。這項分析維持同樣的初值方向,並在各個取樣情況內配對訓練目標與預測起點。
四維 VAR(1) 的係數數目是 16,VAR(4) 是 64,VAR(16) 是 256,因為本研究沒有另加截距。它們的增廣狀態維度分別是 4、16、64;完整線性系統則是 47。只報「輸出都是四維」會隱藏真正需要儲存與更新的狀態量。
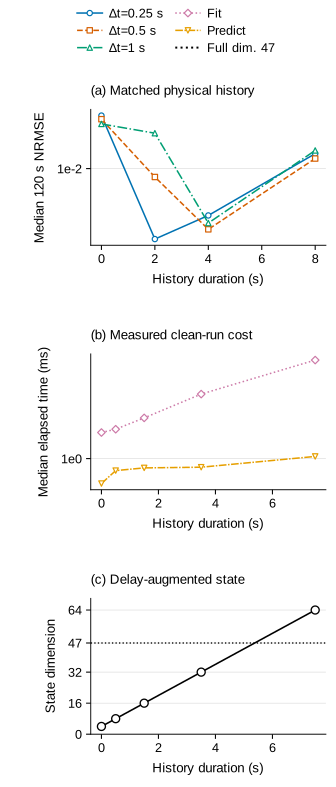
這不表示長歷史模型沒有用途。如果原始微觀狀態根本無法量測,而四個感測輸出容易取得,保留歷史可能仍然是可行方案。但那是一個觀測與實作條件下的取捨,不應只靠「粗粒化」三個字就宣稱節省了所有成本。參數量、狀態量、感測量、訓練成本與每步預測時間,各自回答不同問題。
這項研究留下甚麼,還缺甚麼
Mori 與 Zwanzig 的工作早已說明,投影後的演化可以包含瞬時項、記憶與其餘動力學的影響。Chorin、Hald、Kupferman 的最優預測研究也清楚展示:精確恆等式不等於廉價算法,短記憶近似需要另外的條件。本文的解析環路例子,是把這些觀念放到一個容易核對的狀態選擇中。
現代資料驅動工作進一步把投影與算子學習接起來。Lin、Tian、Perez、Livescu 的回歸投影方法,以逐步殘差構造學習記憶算子,並區分這種做法與一般把所有延遲一起回歸。Lin 與 Lu 的 Wiener 投影研究則提醒我們,若把過去直接納入狀態,顯式記憶項的樣子會改變,但歷史依賴不會因此神奇消失。
圖動力學、紊流粒子及交通預測的近期研究,已經探索更複雜的投影、歷史與神經模型。它們的成果不能由本研究一組小型線性 VAR 取代,本文也不宣稱第一次把 Mori–Zwanzig 用於交通。對交通網絡而言,記住尚餘路段通行時間,與消去跟車模型中的速度模態,雖然都可稱非 Markov,所缺的狀態卻不一樣。
本次比較支持三個有範圍的結論。完整保留的同質 Fourier 配對,不需要額外線性記憶;駕駛員差異令隱藏模態回饋可見模態,有限歷史在不少設定中改善符號與預測;觀測雜訊也會令歷史有用,因此改善幅度不能直接當作物理記憶的證據。
仍然未解決的問題同樣具體。我們沒有研究同一模型跨密度遷移,沒有從真實道路估計駕駛員參數,也沒有證明某個固定記憶長度對所有初值足夠。線性臨界邊界、有限時間預測與有限振幅交通波,是三個相關但不同的目標。尤其對長歷史模型,求解精度與輸入擾動的敏感度,應該和平均誤差一樣被看見。
下一個更有資訊的問題,可能不是把歷史再加倍,而是比較新增一個有物理意義的觀測、加入少量可解釋的輔助狀態,或改善雜訊估計,哪一項更有效。先問當前狀態究竟缺了甚麼,再決定要保存哪段過去,才有機會同時得到準確、可解釋而且真正較小的模型。
參考文獻
- Mori, H. (1965). Transport, Collective Motion, and Brownian Motion. Progress of Theoretical Physics, 33(3), 423–455.
- Zwanzig, R. (1961). Memory Effects in Irreversible Thermodynamics. Physical Review, 124(4), 983–992.
- Zwanzig, R., Nordholm, K. S. J., and Mitchell, W. C. (1972). Memory Effects in Irreversible Thermodynamics: Corrected Derivation of Transport Equations. Physical Review A, 5, 2680.
- Chorin, A. J., Hald, O. H., and Kupferman, R. (2002). Optimal prediction with memory. Physica D, 166(3–4), 239–257.
- Lin, Y. T., Tian, Y., Livescu, D., and Anghel, M. (2021). Data-Driven Learning for the Mori–Zwanzig Formalism: A Generalization of the Koopman Learning Framework. SIAM Journal on Applied Dynamical Systems, 20(4), 2558–2601.
- Lin, Y. T., Tian, Y., Perez, D., and Livescu, D. (2023). Regression-Based Projection for Learning Mori–Zwanzig Operators. SIAM Journal on Applied Dynamical Systems, 22(4), 2890–2926.
- Lin, K. K., and Lu, F. (2021). Data-driven model reduction, Wiener projections, and the Koopman-Mori-Zwanzig formalism. Journal of Computational Physics, 424, 109864.
- Hemati, M. S., Rowley, C. W., Deem, E. A., and Cattafesta, L. N. (2017). De-biasing the dynamic mode decomposition for applied Koopman spectral analysis of noisy datasets. Theoretical and Computational Fluid Dynamics, 31(4), 349–368.
- Yu, Y., Harlim, J., Huang, D., and Li, Y. (2025). Learning coarse-grained dynamics on graph. Physica D, 481, 134801.
- de Wit, X. M., Gabbana, A., Woodward, M., Lin, Y. T., Toschi, F., and Livescu, D. (2026). Data-driven Mori–Zwanzig modeling of Lagrangian particle dynamics in turbulent flows. Proceedings of the National Academy of Sciences, 123(13), e2525390123.
- Tong, H., and Ai, Q. (2026). A deep spatio-temporal Graph Attention Network to learn nonlinear operators for traffic prediction. Physica A, 697, 131741.
- Chen, J., Hu, M., Li, M., Chen, F., and Cao, J. (2026). Routing-induced phase transitions in traffic efficiency of non-Markovian dynamics. Physical Review Research, 8, L012021.
- Bando, M., Hasebe, K., Nakayama, A., Shibata, A., and Sugiyama, Y. (1995). Dynamical model of traffic congestion and numerical simulation. Physical Review E, 51(2), 1035–1042.