想像你手上有兩張藻類分布的航拍圖。第一張圖中,狹長水道左側的高密度區比較明顯;第二張圖中,右側的斑塊變強,左側則逐漸淡去。究竟是水流把物質搬了過去,還是右側環境比較適合生長,左側的藻類同時消失?兩種過程也可能一起發生。
差值圖可以告訴我們哪些位置變了。傳輸圖則更進一步:它在兩個分布之間建立對應關係,甚至畫出很像流動方向的箭頭。這種額外結構很有吸引力,因為它看起來不只是比較,而是在解釋。箭頭彷彿代表移動,源項彷彿代表生長。當圖像足夠合理,我們很容易忘記:兩次拍攝之間的歷史,其實從來沒有被看見。
本文把這個問題放進一個刻意縮小的合成世界。這裏沒有衛星觀測、生物量實測,也沒有從真實生態資料擬合出來的參數。研究對象是一維週期空間上的平滑正密度。我們先指定它們如何改變,再把生成歷史藏起來,只將起點與終點交給一個既有的非平衡最優傳輸方法。
這樣安排的好處是,可以把「方法找到了甚麼」與「實際生成了甚麼」分開比較。方法會按照指定成本,選出一個折衷解。在某些設定中,運輸成本與邊際變化懲罰的分配,接近我們已知歷史的活動預算;在另一些設定中,兩者相差很遠。最重要的是,兩段完全不同的歷史,可以有相同的開始與結束。這時候,即使把最佳化問題解得再準確,也不會憑空得知哪段歷史曾經發生。
這不是否定最優傳輸的用途,而是替它的輸出找回適當的解釋範圍。項目簡介提供較短的版本;以下會從模型、八幅研究圖及反例,逐步討論甚麼額外資訊才真正有助分辨機制。
這個比較發現了甚麼
主實驗完成 4,320 次帶熵正則化的 UOT 擬合,涵蓋 180 個帶有研究類別標籤的端點案例、三種幾何配置,以及固定的成本參數網格。這些 UOT 擬合全部達到預先指定的數值收斂條件。不過,它們是確定性的設計網格,不是自然界中 4,320 次互相獨立的觀測。
收斂並沒有自動賦予輸出物理意義。按照本文的分類慣例,在排除沒有變化的控制例後,靜態成本佔比的標籤與生成歷史作用量的標籤,在純平移設定中的一致率是 62.50%,在均勻生長設定中則是 29.17%。這些百分比只描述指定網格及指定診斷量,不能當成某個環境監測系統的實際辨識準確率。
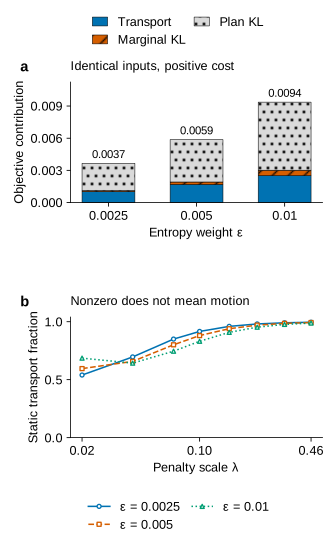
還有一個更直接、毋須分類門檻的提醒:即使前後兩張圖完全相同,而指定的生成歷史既沒有移動也沒有生長,正則化耦合仍然會產生正的運輸成本。在其中一個展示設定中,運輸成本佔比高達 99.29%。這個比例的分母由小量的算法成本構成,不是大量物理活動的證據。
最有力的結果其實不是方法排名,而是一個歧義。我們構造了同時容許「物質移動」與「留在原地生長、消失」兩種歷史的端點對。只接收這兩個端點、又沒有其他不同輔助資訊的估計器,必須對兩段歷史作出相同輸出。這個限制並非 UOT 獨有,只是傳輸圖特別容易令人把數學對應看成真實經過。
一張分布圖可以怎樣改變
空間座標由零走到一,走到盡頭會接回起點。因此,接近零與接近一的位置互相鄰近。這個圓形空間消除了邊界流入、流出;否則,總量改變還可能來自研究區域以外。這只是方便分離機制的建模選擇,不代表真實水道必須形成封閉環。
每個初始密度由兩個平滑週期峰組成,相對權重為 1 與 0.65。三種配置的峰中心分別是 (0.28, 0.46)、(0.28, 0.58) 和 (0.28, 0.72),寬度參數均為 0.045。使用平滑週期峰,可以避免在座標接縫處人為加入導數不連續,令一個本來研究機制的例子被邊界數值問題干擾。
主網格有 256 個格點。傳輸問題接收的是每格的質量,因此密度必須乘上格寬才成為輸入。這個看似細小的處理,決定了不同解析度是否仍在描述同一件事。若直接把密度值當作每格質量,格點加倍時總量也會跟着加倍,成本變化便混合了物理變化與單位錯誤。
指定平移會取最接近的整數格位移,並保留實際使用的距離。例如,要求平移 0.10,在主網格上變成 26/256,即 0.1015625。畫圖與計算都使用這個實際位移,不能在文字中說一個值、在生成器中悄悄使用另一個值。
第一類案例把整個分布平移,總量保持不變。第二類把所有密度乘上同一常數,位置完全不動。第三類一邊移動,一邊施加隨位置平滑變化的局部生長。第四類交換兩個峰的權重,並可再加入整體平移及總量縮放。稍後我們會看到,最後一類可以由兩段不同歷史生成。
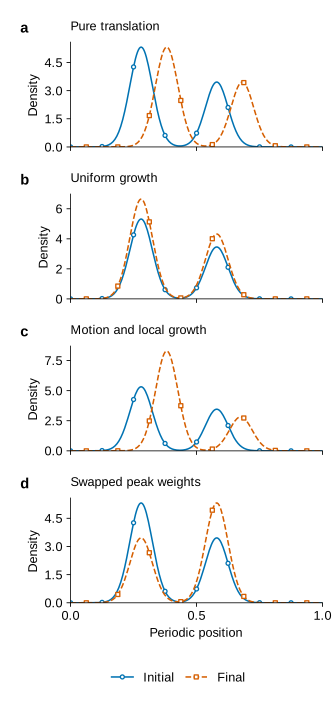
控制例需要保持語義一致。若一個「純平移」案例同時被指定為質量增加至 1.6 倍,它便不再是純平移。相同地,純生長控制例不能偷偷收到非零位移。我們保留原先要求的完整參數排列,但明確標示不適用的軸。因此,7,200 個排列項目對應 4,320 次正式的類別及參數擬合;重複指向同一設定的項目,不會被算成額外證據。
把問題搬到真實影像時,「質量」本身也需要先定義。生物量、人口密度或經校準的濃度場,可能支持總量積分的物理意義;亮度卻不會自動等於生物量。照明、感測器響應及分割門檻都能令影像變亮,而不涉及物質搬移或生物生長。本研究用合成密度避開這層量測問題,並不代表真實應用可以省略它。
真正的歷史,在兩張圖之間
密度可以因移動而改變,也可以因局部產生或消失而改變。一個標準的連續描述是
其中 是速度, 是局部相對生長率;負的 代表損失。這條方程說明兩種機制如何共同改變密度,卻沒有說只看兩個密度分布就一定能把兩者分別求出來。
運輸項是通量的散度。在圓形空間中,流進某個區域的物質必須來自其他位置。反應項則可以改變總量,但它也可以在一些位置為正、另一些位置為負,最後互相抵銷。因此,起點與終點的總量相等,仍然容許大量局部生長與局部損失。積分守恆不等於每一份物質都一直保留。
為了描述一段已指定的歷史,我們計算動能作用量與反應作用量:
它們是經密度加權的活動預算,不是「有多少百分比的生物曾經移動」。速度加倍,動能貢獻會按平方改變;相同的相對生長率,發生在高密度位置時,也比發生在幾乎空白的位置貢獻更多。尺度 改變反應的相對價格,所以同一段混合歷史,在不同價格下也可以有不同的作用量佔比。
這個限定很重要。如果把佔比誤讀成參與移動的質量比例,便會以為它應該不受量綱與價格影響。但這裏比較的是兩種加權積分,並不是逐個追蹤物體後得到的計數。較長的移動距離、較快的增殖率,以及活動發生時的密度,都能改變預算。
均勻生長加上平移,有一條容易核對的生成路徑:
經過一個時間單位,它剛好到達所需端點。純平移令 ,純生長令 。混合案例則把常數生長因子換成依來源位置而變的平滑函數,相應的生長率會跟隨那個物質標籤移動。
「我們指定的路徑」與「成本最低的路徑」必須分開。生成資料時,我們沒有要求自然一定採取某個數學目標下最便宜的行為。最佳化器若選了另一個更便宜的解釋,不代表它把最佳化問題解錯。需要檢查的是:使用者有沒有足夠理由,把那個成本較低的解釋當成真正生成資料的歷史。
非平衡傳輸究竟在最小化甚麼
平衡最優傳輸在保留邊際分布的前提下,配對兩個測度。在離散問題中,非負矩陣 指定每個來源格有多少質量配對到每個目的格。每一橫列的總和對應初始測度,每一直欄的總和對應最終測度。這是一個分布之間的對應,不是帶有個別身份的粒子追蹤。
非平衡傳輸放寬了邊際必須完全相等的條件。它包含多種動態與靜態表述,而幾何、散度及正則化的選擇都會影響含義。Chizat 等人,以及 Liero、Mielke、Savaré 的基礎研究,早已建立這個領域。本文只實作其中一個既有靜態形式,不把它稱為新的 UOT 方法。
設 與 是每格質量,地面成本是圓上最短距離的平方。廣義 Kullback–Leibler 散度定義為
式中的質量項不能省略,因為這些向量未必是總和等於一的機率分布。當 時使用連續延伸;若參考質量 為零而 為正,散度則是無限大。主實驗使用正密度,而另外的數值測試檢查了零支撐的情況。
擬合矩陣最小化的目標是
第一項為移動距離收費。第二項為改變兩端的邊際分布收費。第三項則以原始端點質量的乘積作為參考,正則化整個耦合矩陣。這三個部分共同決定輸出,不能只看圖中最像物理的那一項。
當邊際懲罰較小,不匹配遠處質量就相對便宜;當懲罰較大,解便傾向更接近原來兩端的邊際。熵參數 鼓勵較分散的配對,有助運算,但也會改變最佳化問題本身。它不是一個只影響最後小數位、與模型意義無關的隱藏容差。
本研究把邊際係數設為 ,是為了令單一位置、小幅度質量變化的極限,與前述示意動態作用量作局部校準。這不是兩個模型在所有情況下完全等價的定理。尤其要強調,平方距離配上 KL 邊際懲罰的 UOT,不等同於精確的動態 Wasserstein–Fisher–Rao 問題;WFR 對應的靜態幾何並不相同。
若把所有「運輸加生長」的模型都直接叫作 WFR,便會掩蓋本研究正要檢查的差異。幾個形式可以有相似直覺,甚至在某些極限互相接近,但這不足以把一個形式的成本項逐項當成另一個形式的物理作用量。
我們分別報告運輸項 、邊際懲罰 及正則化項。用來對照生成歷史的診斷量是
這個比例沒有把正則化項直接放進分母,但正則化仍然存在於最佳化問題,也會透過改變矩陣 影響比例。把某一成本項從報告比例中抽走,不等於把它從算法的行為中移除。
這裏刻意把兩種不同的數學量放在一起比較。靜態成本分配不是對真實動態作用量的直接量測。因此,兩者的差異是在檢驗一種解讀方式,而不是在估計同一個統計目標時得到的誤差定理。若它們在某個區域相近,這是值得記錄的經驗證據;若相差很遠,就提醒我們不能直接把成本佔比翻譯成物理活動比例。
兩段歷史,可以有完全相同的證據
現在回到圖 1 最後一格、總量沒有改變的例子。交換峰權重的一種方法,是把較大的組分移到原來較小組分的位置,同時把較小的組分移向另一邊。兩個組分在途中經過彼此、出現重疊;它們合起來的密度,可以在沒有反應項的情況下滿足連續性方程。
當組分重疊時,合成密度的速度是以各自密度加權的速度。我們使用這個合成速度來計算動能作用量,而不是直接相加兩組帶標籤物質的能量。兩者通常不同:為了構造例子而加入的組分標籤,不是估計器實際收到的額外觀測。
另一段歷史可以完全不移動,只在各位置改變密度。由於起點與終點處處為正,我們可以寫成
這條路徑與移動路徑有相同的開始與結束,卻沒有任何運輸,只有局部生長與損失。它在中途的總量也不一定等於共同的端點總量。起點與終點總量相同,沒有要求未被觀測的整段過程都保持守恆。
這不是用另一組終點來冒充同一個問題,也不是把兩條「看起來差不多」的曲線硬說成相同。兩段歷史的端點就是同一對密度。它們的不同發生在中間,而估計器正好沒有收到中間的資訊。
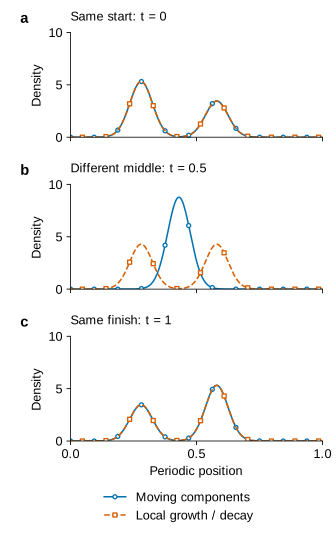
對搬移歷史而言,;對原地反應歷史而言,它等於零。任何只接收端點的診斷量,都必須對兩者給出同一個數值 。因此,
至少有一種解讀會相差半個單位或以上。這個簡單不等式不是新發現的最優傳輸限制,而是把構造例子中的資訊缺口直接寫出來。
固定網格包含 360 次等質量的歧義擬合,橫跨幾何、位移及成本設定。每一個擬合結果都與兩段生成歷史分別對照。觀測到的最小「兩段歷史中較大差異」約為 0.50027,與解析下界一致。多列出一段候選歷史,只是增加評估對象,沒有增加端點本身包含的資訊。
這個反例也沒有宣稱所有生態反問題都無法解決。若限制允許的速度、量測生長率,或觀察中間狀態,其中一段歷史可能不再符合條件。可辨識性永遠相對於模型類別與觀測系統而言。此處無法分辨的原因,是我們只看端點,同時仍容許兩種指定機制。
生長的價格,會改變解釋
實驗把指定平移設為 0、0.03、0.06、0.10、0.16;質量比設為 0.60、0.80、1、1.25、1.60;懲罰尺度有八個值,由 0.02 至 0.46;熵權重則為 0.0025、0.005、0.01。同一對端點在所有適用的成本設定下接受擬合。
這些差異來自模型及正則化選擇,不是重新抽取了一批有噪聲的資料。跨參數的分散程度,是敏感度分析,不是未知環境量的信賴區間。若把每一格當作獨立樣本再算一個非常窄的誤差棒,便會製造本來不存在的統計精確度。
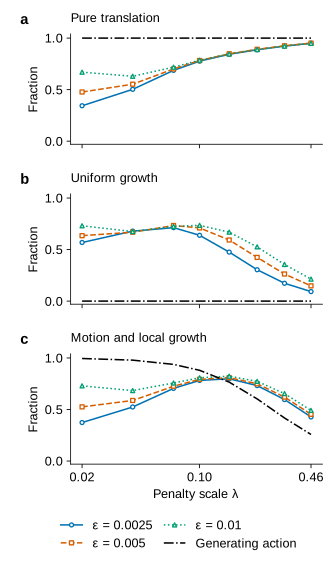
隨着改變邊際的懲罰提高,純平移控制例會愈來愈偏向運輸。這個方向符合直覺:不維持原來對應的代價變高了。但在較弱懲罰下,最低成本的解釋未必願意支付把所有質量搬過生成位移所需的費用。
均勻生長則呈現另一種問題。它的真實動能作用量為零,正則化造成的分散耦合卻仍可配對相近但不同的位置,累積正的運輸成本。提高邊際懲罰,不會令所有效應同時消失,因為邊際調整、耦合分散程度及配對質量之間會互相影響。
混合案例說明了為甚麼標籤改變不一定是數值失敗。靜態成本佔比與生成歷史的加權作用量,都會受反應價格影響。當同一段歷史由「運輸主導」變成「混合」,改變的可能是我們的計價方式,而不是它的物理活動。
為了讓分類可核對,本文把不高於 0.25 的比例稱為反應主導,不低於 0.75 稱為運輸主導,中間則稱為混合。這些是分類慣例,不是自然常數。我們也另外檢查 0.20/0.80 及 0.30/0.70;連續比例始終比三個類別保留更多資訊。
在排除無變化端點後,522 組懲罰尺度掃描之中,有 364 組改變了擬合標籤,即 69.73%。1,392 組熵權重掃描中,有 218 組改變標籤,即 15.66%。前一個百分比包含反應價格改變的影響,不能直接稱為純粹的數值不穩定率。
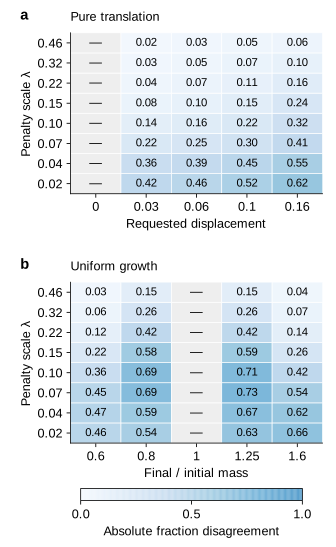
熱圖沒有選出一個對所有問題都正確的懲罰尺度。某個參數在一類案例改善一致性,可能在另一類案例表現較差。若我們因為某個尺度剛好重現了想要的機制才採用它,就需要獨立的科學理由。否則,校準過程已經偷偷把結論放進模型。
在應用中,懲罰尺度最好連接到可說明的物理範圍或任務損失。例如,甚麼程度的增殖在這段時間內合理?跨越某個距離需要多少活動?若沒有這些資訊,也可以把尺度視為比較分布的設計選擇,但此時便不應把其結果包裝成唯一的自然歷史。
擬合很好,也可能回答了另一個問題
既然 UOT 容許改變邊際,「重建誤差」應該怎樣定義?本文比較耦合矩陣橫列總和與初始分布的相對 L1 差,以及直欄總和與最終分布的相對 L1 差。數值愈大,表示耦合直接匹配的質量,與對應端點相差愈多。
另一種做法是把殘差場加回耦合,令兩張輸入圖被完全重建。但那只是一個帳目恆等式,不是成功推斷歷史的證據。原始輸入本來已經知道;把與輸入的差加回去,當然可以還原輸入,卻沒有增加任何關於中間經過的資訊。
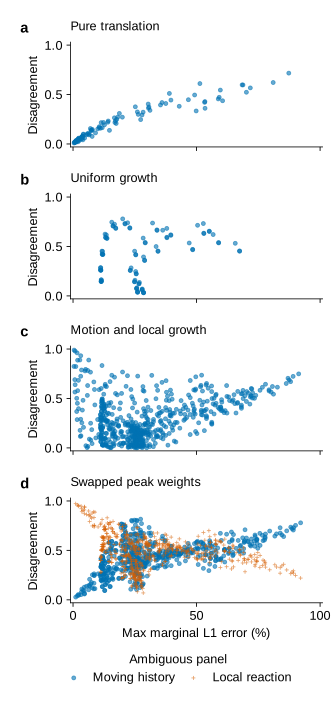
以一個具體設定為例:交換權重的兩個峰位於 0.28 與 0.58,兩端總量相同、沒有整體平移,並使用 、。兩端的邊際誤差都約為 3.565%,靜態運輸成本佔比則為 89.14%。這個比例比較接近搬移歷史,而不是原地反應歷史;然而,兩段歷史給出的觀測完全相同。
擬合沒有造假,最佳化也未必不準。它與端點相符,只是回答了另一個問題:在指定懲罰下,這個耦合與兩張分布圖相容。這件事沒有證明,成本偏好的歷史就是曾經發生的歷史。
作為描述性的閱讀輔助,若要求兩端邊際誤差都不超過 5%,會留下 221 個擬合設定及 257 項有定義的歷史比較。其中 112 項比較的比例差異仍大於 0.25。這個 5% 門檻不是預先登記的成功準則,不是統計信賴程度,也不是適用於所有研究的可接受誤差標準。
這種區分有助我們閱讀漂亮的可視化結果。箭頭是否對照過真實軌跡?生長圖是否有獨立量測支持?還是兩者只是某個端點差異函數的組成部分?三種輸出都可以有價值,但它們允許作者寫出的結論並不一樣。
尤其在模型競賽或跨領域研究中,好的圖像常常比細小的數學限定更容易被記住。因此,圖說有責任交代箭頭的來源:它是觀測、生成真值、估計,還是最低成本插值。只把它統稱為「動態」或「流場」,會令讀者以為已知的事情比實際更多。
為甚麼沒有改變,仍有運輸成本
熵正則化令耦合的質量分散到不只精確對角線的位置。即使兩端的邊際圖完全一樣,把某個來源格配到鄰近但不同的目的格,仍會產生正的平方距離成本。由於問題也容許放寬邊際,邊際懲罰同樣可以保持正值。
此時,運輸成本佔比可以看起來很大,只因為分母中的邊際懲罰更小。比例接近一,只交代分子與分母的相對大小,沒有告訴我們分子是否代表大量、甚至是否代表真實存在的物理活動。
這與「一個很小的數佔另一個很小總數的大部分」是同一回事。若只看百分比而不看絕對成本及無變化控制例,便可能把正則化殘留的計算結構,錯認為幾乎全部由移動造成的環境變化。
處理正則化偏差的一種標準方法,是把交叉成本與兩端各自的自成本比較。對本文這個以質量乘積為參考的精確目標,使用的去偏純量為
其中 與 是兩端總質量,每個 都代表最小化後的目標值。最後的質量修正屬於這個表述;若省略它,不等質量時比較的便是另一個量。
當輸入相同,這個純量等於零,因而修正了差異量的一個重要問題。不過,它沒有把原先分開的運輸與生長成本,變成被觀察到的物理作用量。若把自成本逐項相減,所得分量可能帶有正負號,沒有理由把它們重新包裝成非負的生物活動預算。
把熵權重減小,可以令配對更集中,但同時改變運算難度及條件性。更關鍵的是,即使沒有正則化,圖 2 的相同端點歧義依然存在。數值偏差與結構上無法辨識,是兩個不同問題;處理了前者,不會順便消除後者。
平衡對照刻意忘掉了甚麼
平衡傳輸要求兩端總質量相等。因此,我們的對照先分別把兩端正規化,再用相同的圓形地面成本,求解一個帶熵的平衡問題。它是一個只比較形狀的基準。這個正規化必須明說,因為它正好移除了區分均勻生長與完全不變的資訊。
如果 ,把兩張圖各自除以總量後,不論正的 是多少,都會得到同一個機率分布。任何只收到正規化圖像的方法,都無法推斷已被刪去的那個倍數。這個資訊選擇發生在最佳化之前,不是求解器內部才突然出現的缺點。
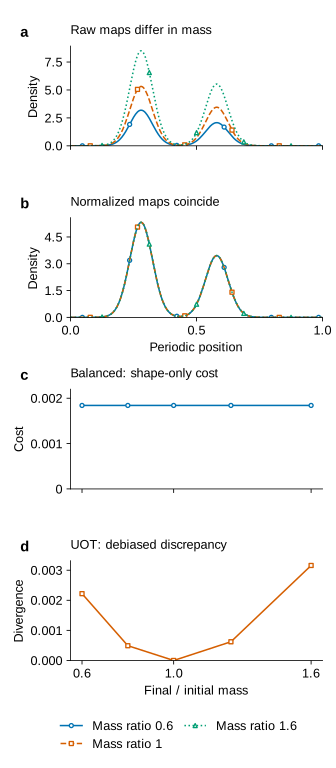
非平衡差異量仍然對總量改變敏感,當研究同時關心數量與空間排列時,這是很實用的特性。但察覺「有東西改變了」,依然不等於辨認出改變的機制。一個有用的分布差異量,沒有必要同時成為因果歷史還原工具。
逐位置的 L1 與 L2 比較提供另一個參照。它們忠實記錄固定座標的變化,卻不會匹配已經位移的形狀。因此,一個尖峰即使只移動少許,也可能在差值圖中留下很大的訊號。傳輸方法加入了空間幾何,讓這類位移結構可以被配對;即使我們不把配對當成粒子軌跡,這個優點仍然存在。
真正的選擇不是「相信傳輸」與「完全不用傳輸」二擇其一,而是按任務保留它能提供的資訊。若目的是比較預報場與觀測場,合適的幾何差異量可能已經足夠;若目的是判斷物質去了哪裏,就需要能支持那個更強問題的額外資料。
有多少差異,其實來自數值運算
UOT 求解器先與單一位置的閉式解、小型問題的獨立凸最佳化,以及既有的 Python Optimal Transport 實作比較。單一位置的例子特別有用,因為每個成本慣例都能直接檢查:
此處 與 是兩個純量質量, 是它們的運輸成本。這個檢查同時涉及質量慣例、熵參考及邊際係數。若其中一個慣例被悄悄改掉,算法仍可能輸出漂亮而合理的矩陣,卻已經在解另一個問題。
在主網格上,選定完整矩陣與獨立實作的相對 L1 差異低於 。進一步收緊求解容差,選定成本比例的改變小於 。在記錄的環境中重複求解,選定矩陣也完全一致。這些檢查處理的是實作與數值精度,並不是機制可辨識性。
網格加密使用各個網格都能精確表示的相同物理位移,不把不同取整位移造成的差異誤認為積分誤差。由 256 加密至 512 格,選定成本比例的最大改變低於 。其中一個較粗的 128 格比較超過嚴格加密門檻;再檢查至 1,024 格後,結果支持主網格的精度。粗網格例外仍保留,沒有被改寫成「所有檢查一律通過」。
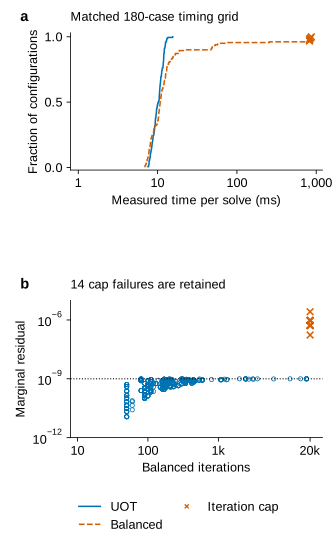
完整網格中,UOT 的求解時間中位數為 10.74 ms,平衡對照為 10.99 ms。兩個總結對不同參數配置的加權並不相同,所以圖 8 中逐個端點配對的比較,更適合用來理解差異。兩者都不能支持某個方法在任何情況下必然更快的結論。
全部 4,320 次主 UOT 擬合及 4,248 次快取自成本擬合均達到指定準則。540 次平衡擬合中,有 14 次未能在固定上限內收斂。獨立實作在相同上限下,也重現了一個分離雙峰例子的緩慢收斂。我們沒有悄悄提高上限、放寬容差,或把這些項目換成看似成功的成本值。
這個區分有科學意義:求解器失敗與機制不可辨識,需要完全不同的回應。前者要求數值調查;後者要求額外資訊或更窄的物理假設。若把兩者都歸納為「模型需要更多訓練」,便會錯過真正要解決的問題。
要怎樣,物理解釋才更可信
圖 2 的中間面板提出了最直接的實驗:在兩個端點之間,再觀察一次。兩段指定歷史的中間形狀不同,因此時間與空間解析度合適的量測,可以分辨這一對候選。但若量測有很大噪聲,或只把整個區域加成一個數字,就未必能做到。資訊增益取決於感測器實際量到了甚麼。
對這一對歷史,中間總量也可能有用,因為原地反應路徑不一定一直保留總質量。不過,這只是這一對候選的特性,不是「量三次總量便能還原任何速度與反應場」的定理。更複雜的歷史仍可能同時配合額外量測。
獨立限制反應率是另一條路。如果已知的生長速度不可能在指定時間內產生觀測到的變化,純反應解釋的範圍就會縮小。相反,速度觀測或可行移動距離的上界,也能排除不合理的快速搬移。這些資訊應作為明確假設或量測進入模型,而不是靠調整懲罰,直到箭頭看起來令人滿意。
帶標籤的物質追蹤更直接。密度分布之間的對應沒有保留個別身份;示蹤物、粒子或可識別物體,可能補上這個缺口。但追蹤也會有抽樣偏差、偵測遺漏及身份錯配,因此完整分析仍要處理它們的不確定性,不能因為畫出了軌跡就宣稱歷史已經完全已知。
這裏有一個實際研究次序。先定義所量測的場與單位,再指定哪些歷史在物理上容許,接着問甚麼觀測可以分辨相互競爭的歷史,最後才選擇最佳化器去總結或估計。若先找一個漂亮的最佳化工具,再替每個成本項補上物理故事,次序便倒轉了。
因此,下一個有科學意義的步驟,不一定是更大的神經網絡。對這個受控問題,更直接的是設計一個額外觀測實驗:加入一張中間分布圖,或一項可量測的反應限制,再檢查哪些歧義仍然存在。這屬於下一個研究問題,不能當成目前端點基準已經完成的成果。
這項工作放在文獻的甚麼位置
非平衡傳輸與 Wasserstein–Fisher–Rao 幾何,早已為移動及質量變化提供成熟的數學語言。它們在反應、平流、擴散問題以及生物流動中的應用,也有大量先例。熵縮放、去偏差異量、加速對偶方法、帶路徑限制的測地線及可擴展分解求解器,處理的是這個既有領域的不同部分。
與本文最接近的實際研究,是 Francis、Cotter、Mittermaier 對空間預報驗證中的帶熵非平衡傳輸分析。他們已經研究空間擾動、質量差異、參數尺度及成本分解。因此,本文不能把參數敏感度圖說成自己發明的新想法。
Ponnoprat、Isobe、Imaizumi 的 2026 年預印本,研究由 UOT 理論最優解所定義的傳輸與生長配對估計。那個目標不是任意選來生成資料的物理歷史。準確估計理論最優配對,與證明它就是實際生成機制,是兩件不同的事。
近期的 WFR-FM 已刊登於 ICLR 2026,WFR-MFM 則以預印本形式提出。兩者都涉及 WFR 相關幾何下的學習式流匹配。它們提供重要背景,但本文沒有使用神經流匹配。某個方法能表示或近似指定幾何路徑,不會單憑這一點就消除上面展示的端點歧義。
因此,本文的貢獻應該保持克制:它是一組經核對的合成比較,以及對一種容易令人信服的解讀方式作出檢查。它沒有主張率先發現可辨識性限制,沒有提出新求解器,也沒有驗證任何真實場域的應用成效。
結論
兩張分布圖可以支持一個有用的距離、一個有用的配對,以及一個有用的最低成本解釋,同時仍然不足以辨認兩者之間曾經發生的事情。這些說法並不矛盾,只是在描述不同層次的推論。
在本研究中,數值最佳化可以相當精確,物理解讀卻仍然脆弱。成本佔比會隨價格及正則化改變;完全相同的圖也可以有正的原始運輸成本。最關鍵的是,一段搬移歷史與一段原地反應歷史,可以提供完全相同的端點證據。
所以,值得問的不只是「耦合擬合得好不好」,還有「甚麼資訊可以排除另一段歷史」。在回答後一個問題之前,非平衡傳輸分解仍然是模型選出來的一種解釋,而不是我們親眼見證熱點如何改變的紀錄。
參考文獻
- Chizat, L., Peyré, G., Schmitzer, B. and Vialard, F.-X. Unbalanced Optimal Transport: Dynamic and Kantorovich Formulations. Journal of Functional Analysis, 2018。原始研究。
- Liero, M., Mielke, A. and Savaré, G. Optimal Entropy-Transport Problems and a New Hellinger–Kantorovich Distance between Positive Measures. Inventiones Mathematicae, 2018。原始研究。
- Liero, M., Mielke, A. and Savaré, G. Optimal Transport in Competition with Reaction: The Hellinger–Kantorovich Distance and Geodesic Curves. SIAM Journal on Mathematical Analysis, 2016。原始研究。
- Cuturi, M. Sinkhorn Distances: Lightspeed Computation of Optimal Transport. NeurIPS, 2013。會議論文。
- Chizat, L., Peyré, G., Schmitzer, B. and Vialard, F.-X. Scaling Algorithms for Unbalanced Optimal Transport Problems. Mathematics of Computation, 2018。原始研究。
- Séjourné, T., Feydy, J., Vialard, F.-X., Trouvé, A. and Peyré, G. Sinkhorn Divergences for Unbalanced Optimal Transport。作者預印本。
- Séjourné, T., Vialard, F.-X. and Peyré, G. Faster Unbalanced Optimal Transport: Translation Invariant Sinkhorn and 1-D Frank–Wolfe. AISTATS, 2022。會議論文。
- Gallouët, T. O., Laborde, M. and Monsaingeon, L. An Unbalanced Optimal Transport Splitting Scheme for General Advection–Reaction–Diffusion Problems. ESAIM: Control, Optimisation and Calculus of Variations, 2019。出版論文。
- Francis, J. J. M., Cotter, C. J. and Mittermaier, M. P. Examining Entropic Unbalanced Optimal Transport and Sinkhorn Divergences for Spatial Forecast Verification. Meteorological Applications, 2025。作者全文。
- Bauer, M., Charon, N., Needham, T. and Nishino, M. Path Constrained Unbalanced Optimal Transport. Nonlinearity, 2025。作者全文。
- Medina, I., Nguyen, T. S. and Schmitzer, B. Domain Decomposition for Entropic Unbalanced Optimal Transport. Computational Optimization and Applications, 2026。出版論文。
- Ponnoprat, D., Isobe, N. and Imaizumi, M. Minimax Optimal Estimation of Transport-Growth Pairs in Unbalanced Optimal Transport. 2026 年預印本。作者全文。
- Peng, Q. and colleagues. WFR-FM: Simulation-Free Dynamic Unbalanced Optimal Transport. ICLR, 2026。官方論文集。
- Wang, X. and colleagues. WFR-MFM: One-Step Inference for Dynamic Unbalanced Optimal Transport. 2026 年預印本。作者全文。