哪一條連線,最值得查核?
假設一個書目資料庫把幾筆紀錄視為同一本書。只要其中一條連線判錯,就可能把不同書籍合併成同一群。查清兩筆紀錄是否真正對應同一實體,需要時間或費用,不能把所有配對全部問一遍。有限預算應先花在哪裏?
CUT-AUDIT-ER 研究一個有明確限制的修復問題:先查核配對,只有答案確認兩端屬於不同實體,才刪除該條既有連線。紀錄本身保留,不任意增加連線或重新建立所有群組。刪除一條邊的效果,取決於它如何改變整個群組的連通性,而不只是兩個端點。因此,查核收益既涉及配對判斷,也涉及圖的結構。
找得準、分數合理、修得好,是三回事
研究把候選搜尋、排序分數是否合理,以及查核後的實際修復分開。搜尋認證可以證明:在這次搜尋的候選池內,沒有另一個行動的計算代理分數更高。然而,如果這個分數未能正確代表預期收益,把分數最大化仍未必選到最有價值的行動。
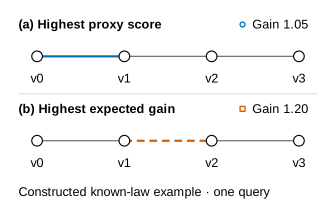
封面採用指定機率律的四節點路徑構造例子。代理分數選擇外側連線,其預期收益為 1.05;中間連線卻有 1.20。這裏的收益是每次付費查核預期減少的錯誤連通紀錄對數,不是真實書目資料庫的觀測結果。例子足夠小,可以精確核對,也說明一個問題:若排序目標本身失準,更徹底的搜尋不會自動修正它。
其他控制則分清預期決策差距與事後比較。知道所有答案後發現更好的行動,不代表當初只掌握有限資訊時,原來的選擇必然不合理。
保留的比較,支持甚麼結論?
自然資料中保留的 241 次 Full 選擇,全部取得各自候選池內的計算代理分數最大值認證。查核答案由參考標籤模擬,並非真人使用者研究;「付費」表示每次查核均扣除預算單位。這些狀態的候選池合共含 73,292 個候選,記錄的完整代理評分則為 256 次。不過,這是評分次數的比較,不能換算成同等倍數的加速:產生候選、檢查合法性及計算上界,仍然需要運算。
在 九組 保留的自然資料群組與預算比較中,Full 與較簡單的 Raw 版本,所得結果及付費查核次序完全相同;Full 的選擇器總時間與工作程序總耗時反而較高。研究因此區分了有效的搜尋認證與已證實的實際效益,並未支持「程序更複雜,所以修得更好、更快」的普遍結論。這些狀態及預算亦互相依賴,不能當成獨立實驗重複來製造信賴區間。
公開研究與下一步
雙語研究網站介紹六組研究圖,可用頁首按鈕切換繁中與 English。GitHub 研究庫公開程式、有限測試、保留證據及獲准分享的既存答案重播。不過,WDC 資料只有彙總結果,無法據此重建所有自然資料圖結構或獨立重跑每次歷史查核。原生 TransClean 與 GraphCR 的比較仍未完成,也未建立新的外部驗證結果。
目前狀態是論文撰寫中,ACIIDS 2027 是擬投稿會議,不是已投稿或已接納公告。正式投稿後才安排較完整的雙語研究長文;此頁先介紹研究問題、可核對結果與限制,不分發論文稿件。
主要結果
- 保留的 241 次自然資料 Full 選擇,均為當時所搜尋候選池內的計算代理分數最大值;不等於修復品質最優。
- 四節點構造例子中,代理分數選擇預期收益 1.05 的行動,而非另一個預期收益 1.20 的可選行動。
- 九組保留的自然資料群組與預算比較中,Full 與 Raw 的結果及付費查核次序相同,Full 的記錄總成本較高。
限制
- 構造機率律不能證明自然資料配對模型已獲完美校準。
- 自然資料狀態及預算互相依賴,不能當成獨立統計重複。
- WDC 只公開彙總證據,無法據此重建所有歷史圖結構或獨立重跑每次查核。
- 原生 TransClean 與 GraphCR 比較仍未完成,不宣稱普遍優勢或已完成新的外部驗證。